LLM hoạt động thế nào: Hiểu máy dự đoán token để dân văn phòng dùng AI hiệu quả
Ban học thuật SeaEdu
Trả lời nhanh
57 từLLM hoạt động bằng cách tính xác suất thống kê để chọn token (mảnh văn bản) kế tiếp dựa trên chuỗi ký tự người dùng nhập vào. Mô hình không hiểu ý nghĩa câu chữ mà chỉ tìm quy luật sắp xếp từ ngữ trong dữ liệu huấn luyện khổng lồ để ghép thành câu hoàn chỉnh.
Hỏi AI về bài viết này
AI có thể sai, hãy kiểm chứng trước khi dùng cho việc quan trọng. Đừng nhập thông tin cá nhân hay dữ liệu khách hàng.
Điểm chính
- Một từ tiếng Việt thường bị tách thành 2 đến 3 token do mã hóa Unicode, nhiều hơn đáng kể so với 1-1.5 token của tiếng Anh vì bộ mã hóa BPE được tối ưu cho dữ liệu tiếng Anh.
- Đặt temperature dưới 0.3 cho tác vụ trích xuất dữ liệu cần độ chính xác cao, và tăng lên trên 0.7 khi cần brainstorm sáng tạo nội dung để AI bớt lan man.
- Giới hạn context window của GPT-4o là 128.000 token mỗi lượt hội thoại, nếu dán tài liệu vượt ngưỡng này hệ thống sẽ tự động cắt bỏ phần nội dung nằm ngoài giới hạn.
- LLM hay bịa thông tin (hallucination) vì cơ chế cốt lõi là dự đoán token hợp lý về ngữ pháp chứ không tra cứu sự thật, bắt buộc phải đối chiếu kết quả với nguồn gốc.
- Không dán bảng lương chứa thông tin cá nhân vào LLM công cộng vì dữ liệu có thể bị lưu trữ để huấn luyện, hãy xóa họ tên và số định danh trước khi đưa vào prompt.
LLM hoạt động thế nào khi dự đoán từng token tiếp theo?
LLM (Large Language Model) là một mô hình ngôn ngữ lớn hoạt động bằng cách tính xác suất và chọn ra token (mảnh văn bản) kế tiếp dựa trên chuỗi ký tự bạn vừa nhập. Thay vì suy nghĩ như con người, LLM chỉ thực hiện phép thống kê hàng tỷ lần để ghép các mảnh chữ lại thành câu hoàn chỉnh.
Ví dụ, khi bạn gõ "Hôm nay trời", LLM sẽ tính toán xác suất xuất hiện của các từ như "nắng", "mưa", "đẹp" rồi chọn từ có điểm số cao nhất để điền vào chỗ trống. Quá trình dự đoán token diễn ra liên tục cho đến khi đủ độ dài hoặc gặp dấu kết thúc.
Lưu ý rằng LLM không hề hiểu ý nghĩa câu chữ. Trợ lý tự động này chỉ giỏi tìm quy luật sắp xếp từ ngữ trong dữ liệu huấn luyện khổng lồ mà nhà cung cấp đã nạp vào hệ thống.
Token trong AI là gì và tại sao nhân viên văn phòng cần đếm token?
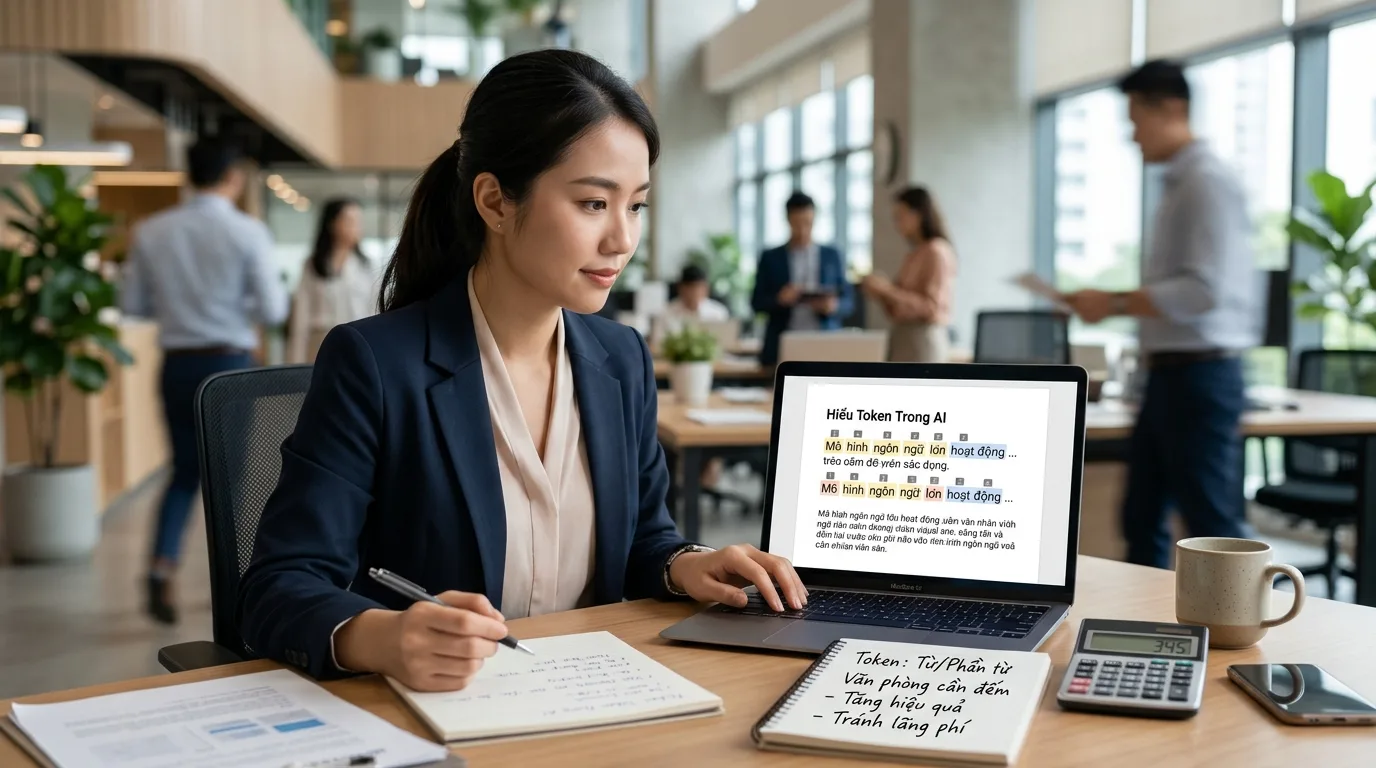
Token trong AI là đơn vị nhỏ nhất mà mô hình ngôn ngữ xử lý, thường tương đương một từ, một phần từ hoặc một dấu câu. Nhân viên văn phòng cần đếm token vì mọi nền tảng AI đều tính phí và giới hạn bộ nhớ dựa trên tổng số token đầu vào lẫn đầu ra.
Ví dụ, gói ChatGPT Plus sử dụng GPT-4o (bản tháng 5/2024) có giới hạn context window (cửa sổ ngữ cảnh) tối đa 128.000 token mỗi lượt hội thoại. Nếu bạn dán một báo cáo tài chính vượt quá ngưỡng này, hệ thống sẽ tự động cắt bỏ phần nội dung nằm ngoài giới hạn.
- Tiếng Anh: Một từ đơn giản thường bằng 1 đến 1.5 token.
- Tiếng Việt: Một từ thường bị tách thành 2 đến 3 token do mã hóa ký tự Unicode khác biệt.
- Dấu câu và khoảng trắng: Mỗi ký tự đặc biệt cũng được tính là một token riêng biệt.
Lưu ý: Việc kiểm soát số lượng token giúp dân văn phòng tránh phát sinh chi phí ngoài dự kiến khi gọi API và đảm bảo luồng agent no-code không bị lỗi tràn bộ nhớ.
Một câu tiếng Việt bị cắt thành bao nhiêu token?
Một câu tiếng Việt bị cắt thành nhiều token hơn đáng kể so với tiếng Anh vì bộ mã hóa BPE (Byte-Pair Encoding) của LLM được tối ưu chủ yếu cho dữ liệu tiếng Anh. Tính đến tháng 10/2026, hầu hết các mô hình phổ biến vẫn xử lý tiếng Việt kém hiệu quả hơn về mặt dung lượng token.
Ví dụ, câu "Tôi đi làm" gồm 3 từ nhưng thường bị bẻ thành khoảng 5 đến 7 token tùy thuộc vào phiên bản tokenizer (công cụ tách từ) của từng nhà cung cấp. Các từ có dấu nặng, dấu huyền càng dễ bị chia nhỏ thành nhiều mảnh ký tự rời rạc.
Lưu ý: Khi viết prompt bằng tiếng Việt cho LLM, bạn nên dùng câu ngắn gọn, rõ nghĩa để tiết kiệm token và giảm thiểu rủi ro trợ lý tự động hiểu sai ngữ cảnh do quá trình tách từ bị vụn.
Chỉnh temperature, top-k, top-p thế nào để AI bớt nói lan man?
Temperature, top-k và top-p là ba tham số cấu hình quyết định mức độ ngẫu nhiên khi LLM chọn token tiếp theo trong danh sách dự đoán. Chỉnh các thông số này về gần 0 buộc AI phải luôn chọn token có xác suất cao nhất, giúp câu trả lời trở nên ổn định và bớt lan man.
Ví dụ, khi yêu cầu AI tóm tắt biên bản cuộc họp, bạn nên đặt temperature = 0.1 để nội dung bám sát dữ kiện gốc. Ngược lại, khi cần brainstorm ý tưởng quảng cáo, việc tăng temperature lên 0.8 sẽ khuyến khích LLM chọn các token ít phổ biến hơn, tạo ra góc nhìn mới lạ.
Tham số | Định nghĩa | Cách áp dụng cho dân văn phòng |
|---|---|---|
temperature | Điều chỉnh độ phẳng của phân phối xác suất token | Đặt dưới 0.3 cho tác vụ trích xuất dữ liệu, trên 0.7 cho sáng tạo nội dung |
top-k | Giới hạn danh sách dự đoán trong K token có xác suất cao nhất | Đặt top-k = 50 để loại bỏ các từ vựng vô nghĩa có xác suất cực thấp |
top-p | Chỉ chọn token từ nhóm có tổng xác suất cộng dồn đạt mức P | Kết hợp top-p = 0.9 cùng temperature thấp để giữ văn phong chuyên nghiệp |
Lưu ý: Theo tài liệu chính thức của OpenAI về ứng dụng AI & AI Agent cho công việc văn phòng (Gen AI, no-code Dify/Copilot Studio), việc thay đổi đồng thời cả ba tham số dễ gây xung đột; người mới bắt đầu chỉ nên tinh chỉnh temperature trước.
Dùng Dify hay Copilot Studio để chỉnh cấu hình đầu ra cho dân marketing?
Dùng Dify hay Copilot Studio để chỉnh cấu hình đầu ra cho dân marketing phụ thuộc vào việc đội ngũ đang vận hành hệ sinh thái phần mềm nào trong doanh nghiệp. Cả hai nền tảng no-code (xây dựng ứng dụng không cần viết mã) đều cho phép kéo thả thanh trượt temperature trực quan mà không cần can thiệp code.
Ví dụ, nếu phòng marketing đang dùng Microsoft 365 hàng ngày, Copilot Studio tích hợp sẵn dữ liệu từ SharePoint và Teams để luồng agent no-code truy cập tài liệu nội bộ nhanh chóng. Trong khi đó, Dify phù hợp hơn khi đội ngũ muốn kết nối linh hoạt nhiều LLM khác nhau như GPT-4o hoặc Claude cho cùng một chiến dịch.
Tiêu chí | Dify | Copilot Studio |
|---|---|---|
Hệ sinh thái tích hợp | Đa nền tảng, hỗ trợ API mở từ nhiều nhà cung cấp LLM | Gắn chặt với Microsoft 365, Dynamics và Azure |
Giao diện chỉnh tham số | Thanh trượt temperature, top-p hiển thị trực tiếp trên node cấu hình | Thiết lập qua hộp thoại Generative AI settings trong từng topic |
Chi phí khởi điểm | Có gói miễn phí giới hạn lượt chạy cho cá nhân | Yêu cầu giấy phép Microsoft 365 doanh nghiệp kèm add-on |
Lưu ý: SeaEdu là đơn vị đào tạo kỹ năng thực chiến, dạy dân văn phòng cách thiết lập các tham số này trên cả Dify lẫn Copilot Studio để tối ưu hóa quy trình làm việc hàng ngày.
Vì sao ChatGPT hay bịa thông tin dù bạn đã gõ prompt rất chi tiết?
ChatGPT hay bịa thông tin vì cơ chế cốt lõi của LLM là dự đoán token có vẻ hợp lý nhất về mặt ngữ pháp chứ không phải tra cứu sự thật từ cơ sở dữ liệu. Hiện tượng này được gọi là hallucination (ảo giác AI), xảy ra khi mô hình cố gắng lấp đầy khoảng trống kiến thức bằng các chuỗi từ ngữ nghe rất thuyết phục nhưng sai lệch hoàn toàn.
Ví dụ, nếu bạn yêu cầu ChatGPT trích dẫn điều khoản lao động cụ thể kèm số hiệu văn bản, trợ lý tự động có thể tự ghép các cụm từ pháp lý quen thuộc thành một điều luật chưa từng tồn tại. Prompt chi tiết chỉ giúp câu trả lời đúng định dạng mong muốn chứ không ngăn được việc LLM bịa đặt dữ kiện.
"Mô hình ngôn ngữ lớn có thể tạo ra thông tin không chính xác hoặc bịa đặt, ngay cả khi được cung cấp hướng dẫn rõ ràng." — Theo tài liệu hướng dẫn an toàn của Anthropic dành cho người dùng doanh nghiệp.
Lưu ý: Dân văn phòng bắt buộc phải đối chiếu mọi số liệu, tên riêng hoặc trích dẫn pháp lý do LLM tạo ra với nguồn tài liệu gốc của công ty trước khi đưa vào báo cáo chính thức.
Knowledge cutoff khiến AI mù tịt về sự kiện mới ra sao?
Knowledge cutoff (điểm cắt kiến thức) là mốc thời gian kết thúc quá trình thu thập dữ liệu huấn luyện, khiến LLM hoàn toàn không biết gì về các sự kiện xảy ra sau ngày đó. Dù bạn hỏi bằng prompt chuẩn xác đến đâu, mô hình ngôn ngữ vẫn chỉ có thể phản hồi dựa trên kho tri thức cũ đã đóng băng.
Ví dụ, một LLM có knowledge cutoff vào tháng 4/2024 sẽ không thể liệt kê các thay đổi trong Luật Đất đai mới được ban hành vào cuối năm 2024. Khi bị ép trả lời, hệ thống thường dùng các token mang tính phỏng đoán dựa trên luật cũ thay vì thừa nhận thiếu sót.
Lưu ý: Để khắc phục giới hạn knowledge cutoff của LLM, dân văn phòng cần áp dụng kỹ thuật RAG (Retrieval-Augmented Generation) nhằm nạp tài liệu nội bộ mới nhất vào ngữ cảnh trước khi yêu cầu trợ lý tự động xử lý.
Nhân sự dùng AI chấm công tính lương có an toàn cho dữ liệu công ty không?
Nhân sự dùng AI chấm công tính lương không an toàn cho dữ liệu công ty nếu bạn dán trực tiếp bảng lương chứa thông tin cá nhân vào khung chat của các LLM công cộng. Mọi đoạn text gửi lên hệ thống đều trở thành dữ liệu đầu vào mà nhà cung cấp có quyền lưu trữ hoặc sử dụng để huấn luyện mô hình ngôn ngữ thế hệ tiếp theo.
Ví dụ, việc copy file Excel chứa mã nhân viên, số CCCD và mức lương thực nhận dán vào ChatGPT bản miễn phí để nhờ viết hàm tính thuế TNCN đồng nghĩa với việc phát tán dữ liệu nhạy cảm ra môi trường bên ngoài. Rò rỉ thông tin từ LLM công cộng vi phạm trực tiếp các quy định bảo vệ dữ liệu cá nhân.
- Xóa bỏ toàn bộ họ tên, số điện thoại và mã định danh trước khi đưa dữ liệu vào prompt.
- Thay thế giá trị thực tế bằng dữ liệu giả định (ví dụ: Lương nhân viên A = 10.000.000 VNĐ) để LLM chỉ xử lý logic tính toán.
- Sử dụng nền tảng AI nội bộ hoặc gói Enterprise có cam kết không dùng dữ liệu khách hàng để train model.
Lưu ý: Tính đến tháng 10/2026, các gói doanh nghiệp của Microsoft Copilot và Dify cài đặt trên server riêng (self-hosted) cung cấp cơ chế cách ly dữ liệu, đảm bảo bảng lương không bị rò rỉ qua các phiên làm việc của LLM.
Các bước thực hiện
- 1
Viết prompt tiếng Việt ngắn gọn để tiết kiệm token và tránh lỗi tràn bộ nhớ
Do cơ chế mã hóa BPE tối ưu cho tiếng Anh, một câu tiếng Việt thường bị bẻ thành 5-7 token thay vì 3 từ như mong đợi. Khi viết prompt cho AI, bạn hãy dùng câu ngắn gọn, rõ nghĩa, loại bỏ từ thừa để giảm thiểu rủi ro trợ lý tự động hiểu sai ngữ cảnh do quá trình tách từ bị vụn. Việc kiểm soát số lượng token còn giúp luồng agent no-code trên Dify hay Copilot Studio không bị lỗi tràn giới hạn context window.
- 2
Chỉnh temperature phù hợp với từng tác vụ văn phòng cụ thể
Temperature quyết định mức độ ngẫu nhiên khi LLM chọn token tiếp theo trong danh sách dự đoán. Nếu bạn cần tóm tắt biên bản cuộc họp hoặc trích xuất dữ liệu, hãy đặt temperature dưới 0.3 để AI luôn chọn token có xác suất cao nhất, giữ nội dung bám sát dữ kiện gốc. Ngược lại, khi brainstorm ý tưởng quảng cáo, tăng temperature lên 0.7-0.8 sẽ khuyến khích mô hình chọn các từ ít phổ biến hơn để tạo góc nhìn mới lạ.
- 3
Xây dựng agent no-code bằng Dify hoặc Copilot Studio tùy hệ sinh thái doanh nghiệp
Nếu phòng ban đang dùng Microsoft 365 hàng ngày, hãy dùng Copilot Studio để luồng agent no-code truy cập tài liệu nội bộ từ SharePoint và Teams nhanh chóng qua hộp thoại Generative AI settings. Nếu đội ngũ marketing muốn kết nối linh hoạt nhiều LLM khác nhau như GPT-4o hoặc Claude cho cùng một chiến dịch, Dify là lựa chọn tốt hơn nhờ hỗ trợ API mở đa nền tảng. Cả hai công cụ đều cho phép kéo thả thanh trượt temperature trực quan mà không cần viết code.
- 4
Áp dụng kỹ thuật RAG để khắc phục ảo giác AI và giới hạn knowledge cutoff
LLM chỉ giỏi tìm quy luật sắp xếp từ ngữ chứ không tra cứu sự thật, nên rất dễ bịa thông tin (hallucination) hoặc mù tịt về sự kiện sau mốc knowledge cutoff. Để khắc phục, dân văn phòng cần áp dụng kỹ thuật RAG (Retrieval-Augmented Generation) nhằm nạp tài liệu nội bộ mới nhất vào ngữ cảnh trước khi yêu cầu AI xử lý. Đồng thời, bắt buộc phải đối chiếu mọi số liệu, tên riêng hoặc trích dẫn pháp lý do LLM tạo ra với nguồn tài liệu gốc của công ty trước khi đưa vào báo cáo chính thức.
- 5
Ẩn danh dữ liệu nhạy cảm trước khi đưa vào prompt để bảo mật thông tin công ty
Tuyệt đối không dán trực tiếp bảng lương chứa mã nhân viên, số CCCD hay mức lương thực nhận vào khung chat của các LLM công cộng vì nhà cung cấp có quyền lưu trữ dữ liệu này. Hãy xóa bỏ toàn bộ họ tên, số điện thoại và thay thế giá trị thực tế bằng dữ liệu giả định để AI chỉ xử lý logic tính toán. Đối với dữ liệu quy mô lớn, doanh nghiệp nên sử dụng gói Enterprise hoặc cài đặt Dify trên server riêng (self-hosted) để đảm bảo cơ chế cách ly dữ liệu an toàn.
Thuật ngữ chính
- LLMLarge Language Model
- LLM là mô hình ngôn ngữ lớn hoạt động bằng cách tính xác suất để dự đoán từng mảnh văn bản (token) tiếp theo, giúp bạn soạn email hoặc tóm tắt biên bản họp. LLM không thực sự hiểu ý nghĩa câu chữ mà chỉ thống kê quy luật từ dữ liệu huấn luyện, nên bạn luôn phải áp dụng nguyên tắc Human-in-the-Loop để kiểm tra lại kết quả trước khi gửi đi.
- TokenToken
- Token là đơn vị nhỏ nhất mà LLM xử lý, thường tương đương một từ, một phần từ hoặc một dấu câu trong đoạn văn bản bạn nhập vào. Nhân viên văn phòng cần đếm token vì các nền tảng AI đều tính phí và giới hạn bộ nhớ dựa trên tổng số này; việc kiểm soát token giúp tránh phát sinh chi phí ngoài dự kiến và đảm bảo luồng agent no-code không bị lỗi tràn bộ nhớ.
- TemperatureTemperature parameter
- Temperature là tham số cấu hình quyết định mức độ ngẫu nhiên khi LLM chọn token tiếp theo, cho phép bạn điều chỉnh AI trả lời cứng nhắc hay sáng tạo. Khi yêu cầu AI trích xuất dữ liệu từ báo cáo tài chính, bạn nên đặt temperature thấp (dưới 0.3) để nội dung bám sát dữ kiện gốc, đồng thời lưu lại audit trail nhằm đối chiếu kết quả sau này.
- HallucinationAI Hallucination
- Hallucination là hiện tượng ảo giác khi LLM tự bịa ra thông tin nghe rất thuyết phục nhưng sai lệch hoàn toàn so với thực tế do cơ chế cốt lõi của nó chỉ là dự đoán token hợp lý về ngữ pháp. Ví dụ khi nhờ AI trích dẫn điều khoản lao động, trợ lý có thể ghép thành điều luật chưa từng tồn tại, bắt buộc người dùng phải tuân thủ Human-in-the-Loop để đối chiếu mọi số liệu với tài liệu gốc của công ty.
- Knowledge cutoffKnowledge cutoff date
- Knowledge cutoff là mốc thời gian kết thúc quá trình thu thập dữ liệu huấn luyện, khiến LLM hoàn toàn không biết gì về các sự kiện xảy ra sau ngày đó. Để khắc phục giới hạn này khi tra cứu chính sách mới, dân văn phòng cần áp dụng kỹ thuật RAG nhằm nạp tài liệu nội bộ mới nhất vào ngữ cảnh, đảm bảo dữ liệu nhạy cảm được bảo mật tuyệt đối.
- RAGRetrieval-Augmented Generation
- RAG là kỹ thuật truy xuất và bổ sung dữ liệu, cho phép LLM tham chiếu trực tiếp tài liệu nội bộ mới nhất của công ty thay vì chỉ dựa vào kiến thức cũ đã đóng băng. Khi áp dụng RAG để tra cứu quy định nhân sự, doanh nghiệp cần đảm bảo cơ chế bảo mật dữ liệu và duy trì audit trail để kiểm soát ai đã truy vấn những tài liệu nào.
Lỗi thường gặp
Sai
Dán nguyên bảng lương có mã nhân viên, số CCCD và mức lương thực vào ChatGPT bản miễn phí để nhờ viết hàm tính thuế TNCN.
Đúng
Xóa bỏ họ tên, số điện thoại, mã định danh hoặc thay bằng dữ liệu giả định (ví dụ: Lương nhân viên A = 10.000.000 VNĐ) trước khi đưa vào prompt, hoặc dùng gói Enterprise/self-hosted.
Mọi đoạn text gửi lên LLM công cộng đều trở thành dữ liệu đầu vào mà nhà cung cấp có quyền lưu trữ hoặc dùng để huấn luyện mô hình thế hệ tiếp theo. Việc dán trực tiếp thông tin cá nhân nhạy cảm đồng nghĩa với phát tán dữ liệu ra môi trường bên ngoài, vi phạm các quy định bảo vệ dữ liệu cá nhân của doanh nghiệp.
Sai
Dán một báo cáo tài chính dài vượt quá 128.000 token vào GPT-4o và kỳ vọng AI sẽ đọc hiểu toàn bộ nội dung từ đầu đến cuối.
Đúng
Kiểm soát số lượng token đầu vào, chia nhỏ báo cáo hoặc áp dụng kỹ thuật RAG để nạp đúng phần tài liệu cần xử lý vào ngữ cảnh.
Mỗi LLM đều có giới hạn context window (cửa sổ ngữ cảnh), ví dụ GPT-4o tối đa 128.000 token. Nếu bạn dán nội dung vượt ngưỡng này, hệ thống sẽ tự động cắt bỏ phần nằm ngoài giới hạn. Hơn nữa, tiếng Việt thường bị bẻ thành 2-3 token mỗi từ do mã hóa Unicode, khiến văn bản nhanh chóng chạm trần bộ nhớ hơn so với tiếng Anh.
Sai
Viết prompt cực kỳ chi tiết và dài dòng bằng tiếng Việt rồi mặc định AI sẽ trả về sự thật chính xác 100% về các điều khoản pháp luật mới ban hành.
Đúng
Luôn đối chiếu mọi số liệu, trích dẫn pháp lý do LLM tạo ra với nguồn tài liệu gốc, và dùng RAG để cung cấp văn bản luật mới nhất cho AI.
LLM hoạt động dựa trên việc dự đoán token có vẻ hợp lý nhất về mặt thống kê chứ không phải tra cứu sự thật. Hiện tượng hallucination (ảo giác AI) khiến mô hình tự ghép các cụm từ pháp lý quen thuộc thành điều luật chưa từng tồn tại. Ngoài ra, do knowledge cutoff (điểm cắt kiến thức), AI hoàn toàn mù tịt về các sự kiện xảy ra sau ngày kết thúc huấn luyện.
Sai
Khi xây dựng AI Agent no-code trên Dify, kéo thanh trượt tăng đồng thời temperature, top-k và top-p lên mức cao nhất để AI sáng tạo tối đa khi tóm tắt biên bản cuộc họp.
Đúng
Với tác vụ trích xuất hay tóm tắt biên bản, đặt temperature dưới 0.3 (ví dụ 0.1). Người mới chỉ nên tinh chỉnh temperature trước, tránh thay đổi cả ba tham số cùng lúc.
Temperature, top-k và top-p quyết định độ ngẫu nhiên khi chọn token. Tăng cao khuyến khích AI chọn token ít phổ biến, phù hợp brainstorm nhưng gây lan man, sai lệch khi cần bám sát dữ kiện gốc. Theo tài liệu của OpenAI, việc thay đổi đồng thời cả ba tham số dễ gây xung đột, làm luồng agent no-code hoạt động thiếu ổn định.
Câu hỏi thường gặp
LLM hoạt động như thế nào khi dự đoán từ tiếp theo?
LLM (mô hình ngôn ngữ lớn) hoạt động bằng cách tính xác suất và chọn ra token kế tiếp dựa trên chuỗi ký tự bạn vừa nhập. Thay vì suy nghĩ như con người, LLM chỉ thực hiện phép thống kê hàng tỷ lần để ghép các mảnh chữ lại thành câu hoàn chỉnh. Quá trình này diễn ra liên tục cho đến khi đủ độ dài hoặc gặp dấu kết thúc, và LLM không hề hiểu ý nghĩa thực sự của câu chữ.
Token trong AI là gì và tại sao cần đếm token?
Token là đơn vị nhỏ nhất mà mô hình ngôn ngữ xử lý, thường tương đương một từ, một phần từ hoặc một dấu câu. Nhân viên văn phòng cần đếm token vì mọi nền tảng AI đều tính phí và giới hạn bộ nhớ dựa trên tổng số token đầu vào lẫn đầu ra. Ví dụ, ChatGPT Plus dùng GPT-4o có giới hạn 128.000 token mỗi lượt hội thoại, vượt quá sẽ bị cắt bỏ nội dung.
Một câu tiếng Việt bị cắt thành bao nhiêu token so với tiếng Anh?
Câu tiếng Việt bị cắt thành nhiều token hơn đáng kể so với tiếng Anh vì bộ mã hóa BPE của LLM được tối ưu chủ yếu cho tiếng Anh. Một từ tiếng Anh thường bằng 1 đến 1.5 token, trong khi một từ tiếng Việt thường bị tách thành 2 đến 3 token. Ví dụ, câu "Tôi đi làm" gồm 3 từ nhưng thường bị bẻ thành khoảng 5 đến 7 token tùy phiên bản tokenizer.
Chỉnh temperature, top-k, top-p thế nào để AI bớt nói lan man?
Để AI bớt nói lan man, bạn nên chỉnh temperature về gần 0, buộc AI luôn chọn token có xác suất cao nhất giúp câu trả lời ổn định. Khi tóm tắt biên bản cuộc họp, đặt temperature = 0.1 để bám sát dữ kiện gốc. Ngược lại, khi brainstorm ý tưởng quảng cáo, tăng temperature lên 0.8 sẽ khuyến khích LLM tạo ra góc nhìn mới lạ hơn.
Vì sao ChatGPT hay bịa thông tin dù prompt rất chi tiết?
ChatGPT hay bịa thông tin vì cơ chế cốt lõi của LLM là dự đoán token hợp lý về mặt ngữ pháp chứ không phải tra cứu sự thật. Hiện tượng hallucination (ảo giác AI) xảy ra khi mô hình lấp đầy khoảng trống kiến thức bằng các chuỗi từ nghe thuyết phục nhưng sai lệch. Prompt chi tiết chỉ giúp đúng định dạng mong muốn chứ không ngăn được việc LLM bịa đặt dữ kiện.
Dùng AI chấm công tính lương có an toàn cho dữ liệu công ty không?
Dùng AI chấm công tính lương không an toàn nếu bạn dán trực tiếp bảng lương chứa thông tin cá nhân vào khung chat của LLM công cộng. Mọi đoạn text gửi lên đều trở thành dữ liệu đầu vào mà nhà cung cấp có thể lưu trữ hoặc dùng để huấn luyện. Để đảm bảo an toàn, hãy xóa bỏ họ tên, số CCCD trước khi đưa vào prompt hoặc sử dụng nền tảng AI nội bộ có cam kết bảo mật dữ liệu.
Biên tậpAI hỗ trợ soạn nháp, Ban học thuật SeaEdu kiểm chứng và chịu trách nhiệm cuối.