Xây knowledge base cho AI: 5 bước chuẩn hóa tài liệu Word Excel tránh ảo giác
SeaEdu
Blog AI cho dân văn phòng
Tóm tắt
31 từ5 bước chuẩn hóa Word, Excel giúp xây knowledge base AI chính xác: làm sạch dữ liệu, phân loại, chuyển Markdown, xử lý bảng và semantic chunking để tránh ảo giác.
Hỏi AI về bài viết này
AI có thể sai, hãy kiểm chứng trước khi dùng cho việc quan trọng. Đừng nhập thông tin cá nhân hay dữ liệu khách hàng.
Chuẩn hóa dữ liệu đầu vào là nền tảng sống còn để xây dựng knowledge base cho AI chính xác và hạn chế tối đa hiện tượng ảo giác trong doanh nghiệp.
Tại sao nguyên tắc Garbage In Garbage Out quyết định độ chính xác của RAG?
Nguyên tắc Garbage In, Garbage Out khẳng định quy trình chuẩn hóa dữ liệu phi cấu trúc từ Word và Excel quyết định trực tiếp đến độ chính xác của mô hình RAG trong doanh nghiệp. Hệ thống truy xuất tăng cường không có khả năng tự sửa chữa các lỗi sai lệch nằm sẵn trong tài liệu gốc mà chỉ phản ánh trung thực chất lượng thông tin được nạp vào.
Khi tài liệu chứa định dạng lộn xộn, mã ký tự lỗi hoặc cấu trúc bảng biểu vỡ nát, vector embedding sẽ mã hóa cả những nhiễu này thành ngữ nghĩa sai lệch. Kết quả là trợ lý tự động trả về thông tin bịa đặt hoặc trích dẫn nhầm lẫn dù thuật toán tìm kiếm hoạt động hoàn hảo.
Việc đầu tư thời gian làm sạch dữ liệu trước khi index mang lại hiệu quả cao hơn nhiều so với việc tinh chỉnh prompt hay thay đổi mô hình nhúng. Một knowledge base sạch giúp giảm thiểu đáng kể chi phí tính toán do loại bỏ được các token vô nghĩa và tăng tốc độ truy vấn thực tế.
Bước 1: Làm sạch metadata và sửa lỗi OCR trong file Word Excel cũ
Làm sạch dữ liệu là quá trình loại bỏ có hệ thống các yếu tố gây nhiễu như metadata ẩn, header/footer lặp lại, số trang và sửa lỗi nhận diện ký tự quang học. Bước này đảm bảo luồng agent no-code chỉ tiếp nhận nội dung cốt lõi thay vì lãng phí tài nguyên xử lý vào các thành phần trang trí văn bản.
Các file Word và Excel lưu trữ lâu năm thường chứa mã định dạng thừa kế hoặc lỗi font chữ khiến quá trình trích xuất văn bản bị gián đoạn. Bạn cần sử dụng công cụ chuyên dụng để chuẩn hóa bảng mã về UTF-8 và xóa bỏ các trường ẩn trước khi đưa vào pipeline xử lý.
- Loại bỏ hoàn toàn header, footer, số trang và chú thích không liên quan đến nội dung chính.
- Sửa lỗi chính tả và ký tự đặc biệt phát sinh từ quá trình scan hoặc chuyển đổi PDF sang Word.
- Xóa metadata cá nhân nhạy cảm và thông tin phiên bản tệp tin cũ không còn giá trị tham chiếu.
- Chuẩn hóa định dạng ngày tháng và đơn vị tiền tệ về một tiêu chuẩn duy nhất.
Bước 2: Phân loại tài liệu theo taxonomy nhất quán để truy xuất đúng ngữ cảnh
Phân loại tài liệu theo taxonomy là việc thiết lập hệ thống thẻ gán nhãn nhất quán dựa trên phòng ban, chủ đề hoặc loại văn bản để AI truy xuất đúng ngữ cảnh. Thay vì tìm kiếm tràn lan trong toàn bộ kho dữ liệu, hệ thống sẽ lọc ra tập hợp con phù hợp nhất với ý định người dùng.
Một cấu trúc phân loại rõ ràng giúp giảm thiểu xung đột thông tin khi nhiều tài liệu đề cập cùng một từ khóa nhưng ở các bối cảnh khác nhau. Ví dụ, quy trình "duyệt chi" của phòng Kế toán và phòng Nhân sự cần được gắn thẻ riêng biệt để tránh việc trợ lý tự động trộn lẫn hai luồng phê duyệt này.
Theo hướng dẫn nhà cung cấp về ứng dụng AI & AI Agent cho công việc văn phòng (Gen AI, no-code Dify/Copilot Studio), việc gắn thẻ metadata có cấu trúc là bắt buộc để tối ưu hóa khả năng lọc ngữ nghĩa. Thiếu bước này, hệ thống RAG dễ dàng rơi vào trạng thái nhiễu loạn thông tin khi quy mô tài liệu vượt quá vài trăm tệp.
Bước 3: Chuyển đổi văn bản sang Markdown hoặc JSON có cấu trúc phân cấp
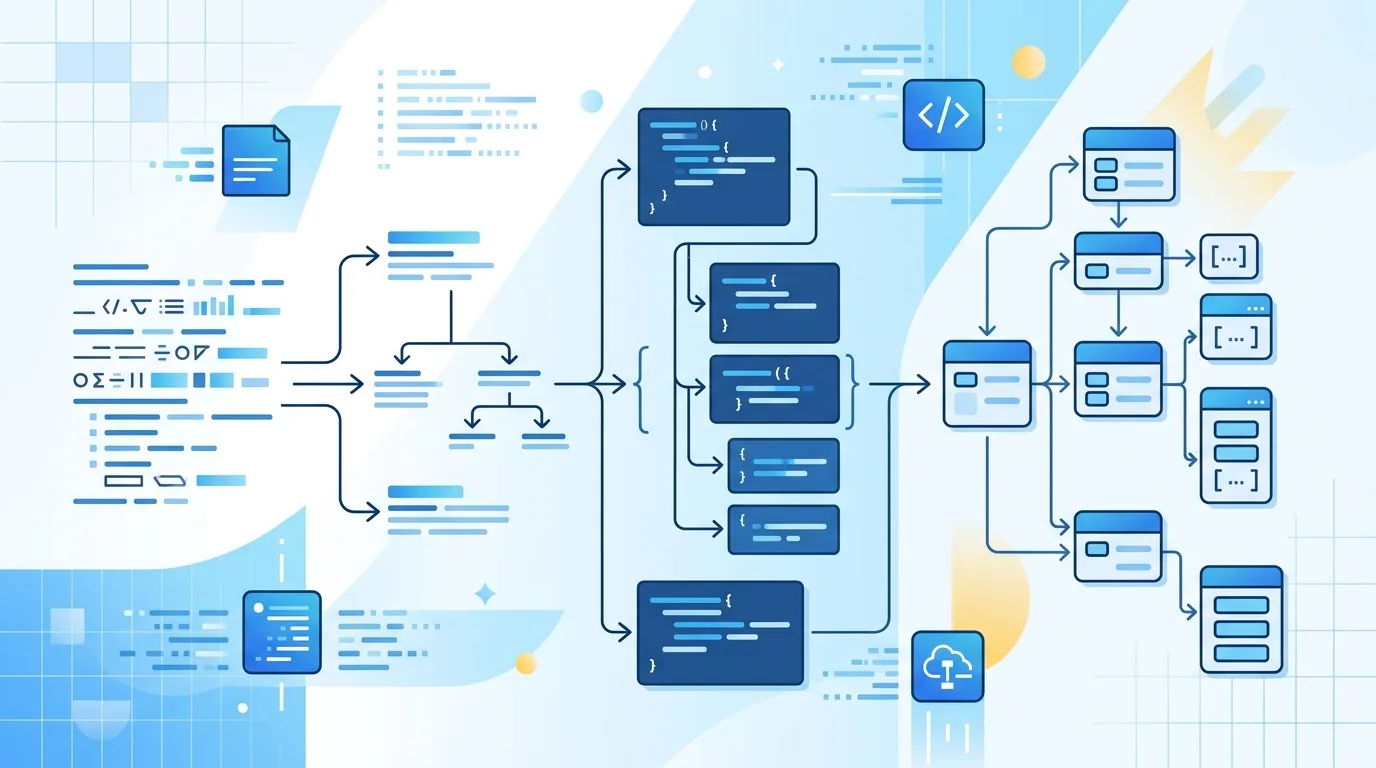
Chuyển đổi sang định dạng có cấu trúc là quá trình biến đổi văn bản thuần túy thành Markdown hoặc JSON với các thẻ tiêu đề và danh sách rõ ràng. Định dạng này giúp mô hình ngôn ngữ lớn nhận diện chính xác mối quan hệ cha-con giữa các đoạn văn và ý tưởng.
Văn bản phẳng không có dấu hiệu phân cấp khiến AI khó phân biệt đâu là tiêu đề chương, đâu là nội dung diễn giải hay ví dụ minh họa. Khi chuyển sang Markdown, các thẻ H1, H2, H3 đóng vai trò như mỏ neo ngữ nghĩa giúp quá trình chunking giữ được tính logic của tài liệu gốc.
Định dạng JSON đặc biệt hữu ích cho các tài liệu kỹ thuật hoặc quy trình có nhiều trường dữ liệu cố định. Cấu trúc key-value giúp tách biệt rõ ràng giữa tên thuộc tính và giá trị, ngăn chặn tình trạng AI gộp nhầm thông tin của các mục khác nhau vào cùng một câu trả lời.
Bước 4: Xử lý bảng biểu Excel thành text mô tả hoặc CSV chuẩn hóa
Xử lý bảng biểu là bước chuyển đổi ma trận ô tính thô sang dạng text mô tả hoặc CSV chuẩn hóa để AI hiểu đúng ngữ nghĩa dữ liệu. Mô hình ngôn ngữ không đọc bảng tính theo hàng cột như con người mà xử lý chúng dưới dạng chuỗi tuyến tính nên rất dễ suy luận sai nếu giữ nguyên định dạng gốc.
Mỗi bảng tính phức tạp nên được kèm theo một đoạn văn bản tóm tắt mô tả nội dung, các trục dữ liệu và đơn vị đo lường. Việc bổ sung ngữ cảnh này giúp trợ lý tự động hiểu được ý nghĩa của các con số thay vì chỉ liệt kê chúng một cách máy móc.
Định dạng gốc | Vấn đề thường gặp | Giải pháp chuẩn hóa |
|---|---|---|
Bảng Excel nhiều sheet | Mất liên kết ngữ cảnh giữa các tab | Gộp thành CSV kèm cột phân loại sheet |
Ô gộp (merged cells) | Dữ liệu bị trống khi trích xuất | Bỏ gộp và điền đầy đủ giá trị cho từng dòng |
Công thức tính toán | Hiển thị mã hàm thay vì kết quả | Chuyển sang giá trị tĩnh (paste as values) |
Bước 5: Áp dụng semantic chunking với độ dài 256-512 tokens thay vì cắt cố định
Semantic chunking là chiến lược phân đoạn dữ liệu dựa trên ranh giới ý nghĩa hoàn chỉnh thay vì cắt cứng nhắc theo số lượng ký tự cố định. Phương pháp này đảm bảo mỗi đoạn dữ liệu chứa trọn vẹn một ý tưởng, giúp vector embedding nắm bắt chính xác ngữ cảnh mà không bị đứt quãng.
Độ dài tối ưu cho mỗi đoạn dữ liệu sau khi phân đoạn theo phương pháp semantic chunking thường nằm trong khoảng từ 256 đến 512 tokens. Khoảng này cân bằng tốt giữa việc giữ đủ ngữ cảnh để AI hiểu và đảm bảo độ chính xác khi truy xuất thông tin cụ thể.
Cắt văn bản theo ký tự cố định thường xé lẻ câu hoặc tách rời tiêu đề khỏi nội dung mô tả bên dưới. Hậu quả là khi người dùng hỏi về một khái niệm, hệ thống có thể trả về đoạn văn thiếu mất phần định nghĩa nằm ở chunk liền kề trước đó.
Đo lường chỉ số Faithfulness và Answer Relevancy bằng test set thực tế trước khi triển khai
Đo lường chất lượng là quy trình đánh giá khách quan dựa trên bộ câu hỏi kiểm thử thực tế để xác định mức độ trung thực và liên quan của câu trả lời. Chỉ số Faithfulness phản ánh tỷ lệ thông tin trong câu trả lời có nguồn gốc từ tài liệu gốc, trong khi Answer Relevancy đo lường mức độ đáp ứng đúng trọng tâm câu hỏi.
Bạn cần xây dựng bộ test set bao gồm ít nhất 50-100 cặp câu hỏi và câu trả lời chuẩn được chuyên gia thẩm định trước khi đưa hệ thống vào vận hành. Quy trình đánh giá chất lượng dữ liệu giúp phát hiện sớm nguy cơ ảo giác của AI do dữ liệu gốc mâu thuẫn hoặc thiếu sót thông tin quan trọng.
Việc đo lường phải được thực hiện lặp lại mỗi khi có sự thay đổi trong kho tài liệu hoặc cấu hình chunking. Dựa trên kết quả đánh giá, đội ngũ vận hành có thể quay lại các bước làm sạch hoặc phân loại để khắc phục điểm yếu cụ thể thay vì phỏng đoán nguyên nhân sai sót.
Câu hỏi thường gặp
Tại sao cần chuẩn hóa dữ liệu Word Excel trước khi xây dựng knowledge base cho AI?
Chuẩn hóa dữ liệu giúp loại bỏ nhiễu và lỗi định dạng để tránh hiện tượng AI ảo giác do nguyên tắc Garbage In Garbage Out. Dữ liệu sạch giúp hệ thống RAG truy xuất chính xác, giảm chi phí tính toán và tăng tốc độ phản hồi thực tế cho người dùng doanh nghiệp.
Làm thế nào để làm sạch file Word Excel cũ trước khi nạp vào AI?
Bạn cần xóa metadata ẩn, header/footer lặp lại và sửa lỗi OCR để chỉ giữ lại nội dung cốt lõi. Đồng thời hãy chuẩn hóa bảng mã về UTF-8, sửa lỗi chính tả và định dạng lại ngày tháng, tiền tệ theo một tiêu chuẩn duy nhất để đảm bảo tính nhất quán.
Phân loại tài liệu theo taxonomy giúp ích gì cho hệ thống RAG?
Việc gắn thẻ metadata nhất quán giúp AI lọc đúng ngữ cảnh và tránh xung đột thông tin khi nhiều tài liệu chứa cùng từ khóa. Hệ thống sẽ truy xuất chính xác tập hợp con phù hợp thay vì tìm kiếm tràn lan, đặc biệt quan trọng khi kho dữ liệu vượt quá vài trăm tệp.
Nên chuyển đổi văn bản sang định dạng nào để AI hiểu tốt nhất?
Bạn nên chuyển văn bản sang Markdown hoặc JSON có cấu trúc phân cấp để mô hình nhận diện rõ mối quan hệ cha-con giữa các ý tưởng. Các thẻ tiêu đề trong Markdown đóng vai trò mỏ neo ngữ nghĩa, còn JSON giúp tách biệt thuộc tính và giá trị trong tài liệu kỹ thuật.
Cách xử lý bảng biểu Excel để tránh AI suy luận sai là gì?
Hãy chuyển bảng tính sang text mô tả hoặc CSV chuẩn hóa kèm tóm tắt ngữ cảnh vì AI xử lý dữ liệu dưới dạng chuỗi tuyến tính. Bạn cần bỏ ô gộp, chuyển công thức thành giá trị tĩnh và gộp các sheet thành CSV kèm cột phân loại để giữ liên kết ngữ cảnh.
Semantic chunking khác gì so với cắt văn bản theo ký tự cố định?
Semantic chunking phân đoạn dựa trên ranh giới ý nghĩa hoàn chỉnh với độ dài 256-512 tokens thay vì cắt cứng nhắc theo số ký tự. Phương pháp này đảm bảo mỗi đoạn chứa trọn vẹn một ý tưởng, giúp vector embedding nắm bắt chính xác ngữ cảnh mà không bị đứt quãng thông tin.
Biên tậpAI hỗ trợ soạn nháp, Ban biên tập SeaEdu kiểm chứng và chịu trách nhiệm cuối.
Đọc tiếp
 Tương lai việc làm AI 2027-2030: 5 dự báo về vị trí hybrid người-máy16/9/2026 · Tin tức
 AI nghề hành chính: 6 nhiệm vụ bị thay thế và 4 kỹ năng quản trị mới6/9/2026 · Tin tức
 Prompt Engineering Là Gì? Kỹ Năng Vàng Dân Văn Phòng Cần Nắm Ngay7/7/2026 · Tin tức
 Khóa Học AI Cho Dân Văn Phòng 2026: Lộ Trình 4 Cấp Từ Số 07/7/2026 · Tin tức