Tóm tắt báo cáo dài 50 trang bằng AI: chia đoạn thế nào để không bỏ sót ý quan trọng?
Chia nhỏ báo cáo 50 trang theo chương mục, kết hợp overlapping và quy trình Map-Reduce giúp AI tóm tắt chính xác, không bỏ sót ý. Triển khai trên Dify để bảo mật dữ liệu nội bộ.
SeaEdu
Blog AI cho dân văn phòng
Trả lời nhanh
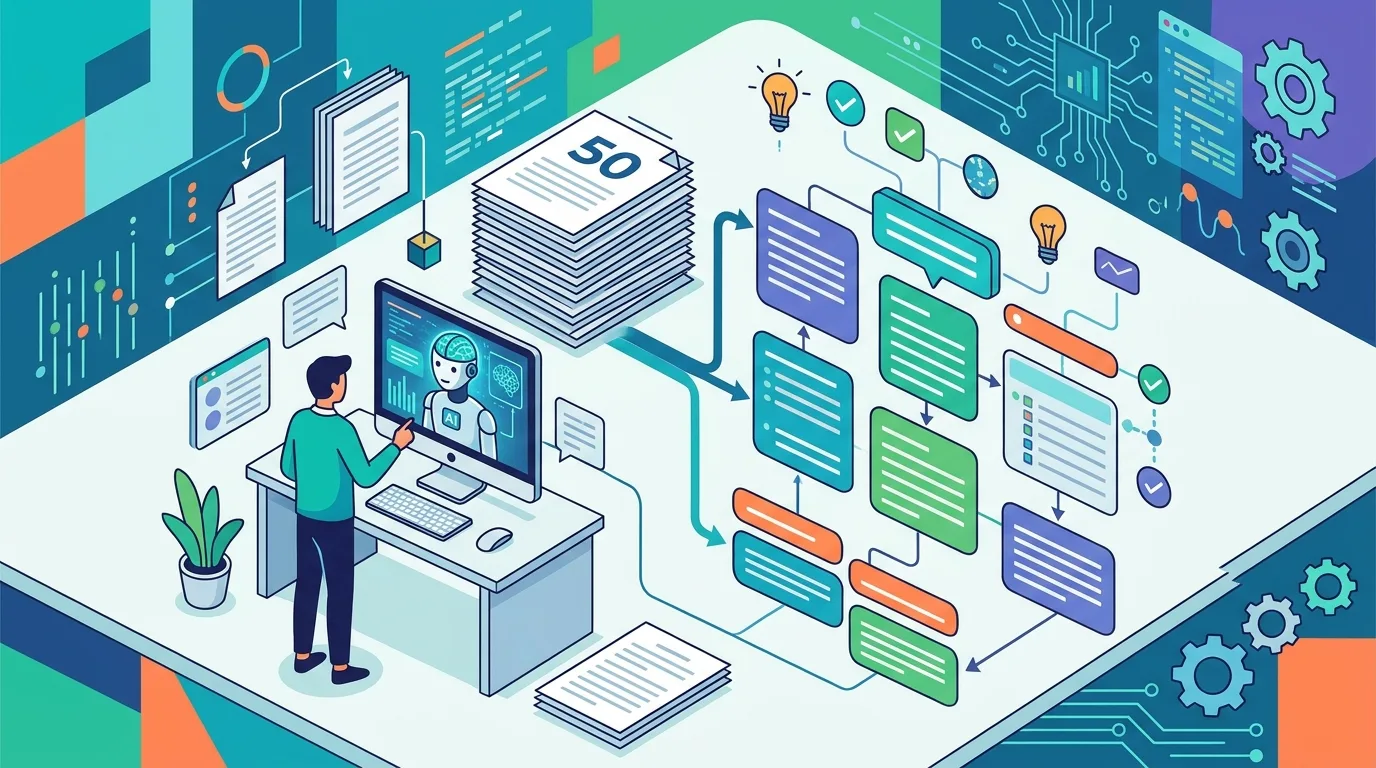
59 từCách chia đoạn tối ưu là cắt theo ranh giới ngữ nghĩa tự nhiên như tiêu đề chương thay vì số từ cố định. Mỗi chunk cần lặp lại 10-20% nội dung cuối của đoạn trước (overlapping) và áp dụng quy trình Map-Reduce để AI tóm tắt từng phần rồi gộp lại, tránh hiện tượng Lost in the Middle.
Hỏi AI về bài viết này
AI có thể sai, hãy kiểm chứng trước khi dùng cho việc quan trọng. Đừng nhập thông tin cá nhân hay dữ liệu khách hàng.
Điểm chính
- Chia chunk theo tiêu đề chương hoặc phần trọn vẹn giúp giữ nguyên mạch lập luận, nếu dùng số từ thì nên đặt mốc khoảng 1.500 từ mỗi đoạn thay vì 300 từ.
- Kỹ thuật Overlapping yêu cầu lặp lại 10-20% nội dung hoặc 1-2 đoạn văn cuối chunk trước sang đầu chunk sau để duy trì liên kết ngữ cảnh giữa các phần.
- Quy trình Map-Reduce phù hợp cho tài liệu từ 20 trang trở lên, gồm bước tóm tắt từng chunk riêng lẻ rồi gộp lại bằng một lượt gọi AI mới để tạo bản tổng hợp cuối cùng.
- Đưa báo cáo nội bộ lên AI đám mây công cộng tiềm ẩn rủi ro rò rỉ dữ liệu, nên triển khai nền tảng no-code như Dify trên máy chủ nội bộ để giữ thông tin trong tường lửa công ty.
- Trên Dify, người dùng cấu hình node Document Extractor chia văn bản theo thẻ H2 với overlapping 15%, sau đó nối chuỗi qua hai node LLM thực hiện lần lượt bước Map và Reduce.
Chunking là kỹ thuật chia nhỏ tài liệu dài thành các đoạn có ngữ nghĩa, giúp AI tóm tắt báo cáo 50 trang mà không bỏ sót luận điểm chính do giới hạn context window.
Context window là gì và tại sao AI hay bỏ sót ý giữa báo cáo dài 50 trang?
Context window là cửa sổ ngữ cảnh, chỉ lượng ký tự tối đa mà một mô hình ngôn ngữ lớn (LLM) có thể xử lý trong một lần yêu cầu duy nhất. Khi văn bản đầu vào vượt quá giới hạn này, hệ thống buộc phải cắt bớt nội dung hoặc nén thông tin, dẫn đến việc mất dữ liệu quan trọng.
Hiện tượng Lost in the Middle xảy ra khi AI bỏ sót thông tin quan trọng nằm ở giữa văn bản dài do giới hạn context window. Các nghiên cứu về hành vi của LLM chỉ ra rằng mô hình thường ghi nhớ tốt phần mở đầu và kết thúc, nhưng xử lý kém phần thân bài nếu độ dài vượt ngưỡng tối ưu.
Tính đến tháng 10/2026, nhiều mô hình phổ biến hỗ trợ context window từ 128K đến hàng triệu token, nhưng chất lượng trích xuất thông tin vẫn giảm khi tài liệu quá dài. Chia nhỏ dữ liệu bằng chunking là giải pháp cốt lõi để AI tóm tắt tài liệu dài hiệu quả thay vì phụ thuộc hoàn toàn vào dung lượng bộ nhớ tạm.
Nên chia chunk theo số từ cố định hay theo tiêu đề chương khi tóm tắt báo cáo tài chính?
Chia chunk theo ranh giới ngữ nghĩa tự nhiên như chương hoặc tiêu đề mang lại kết quả tóm tắt báo cáo tài chính chính xác hơn so với việc cắt ngang bằng số từ cố định. Một đoạn văn bị cắt dở sẽ làm mất mạch lập luận về doanh thu hay chi phí, khiến AI hiểu sai bối cảnh.
Khi áp dụng cho báo cáo tài chính, mỗi chunk nên tương ứng với một phần trọn vẹn: bảng cân đối kế toán, báo cáo kết quả kinh doanh, hoặc thuyết minh riêng biệt. Việc giữ nguyên cấu trúc chương mục giúp trợ lý tự động nắm bắt đúng logic trình bày của kiểm toán viên.
Nếu bắt buộc phải dùng giới hạn số từ, người thực hiện cần chọn mốc đủ lớn để bao trọn ít nhất một luận điểm hoàn chỉnh. Ví dụ, đặt mức 1.500 từ cho mỗi chunk thay vì 300 từ sẽ giảm thiểu rủi ro đứt gãy ngữ nghĩa giữa các đoạn phân tích dòng tiền.
Kỹ thuật Overlapping giữ liên kết ngữ cảnh giữa các chunk như thế nào?
Kỹ thuật Overlapping yêu cầu lặp lại khoảng 10-20% nội dung hoặc 1-2 đoạn văn cuối chunk trước sang đầu chunk sau để duy trì bối cảnh liên kết. Phương pháp này đảm bảo câu chuyển ý không bị tách rời khỏi cả hai phần dữ liệu liền kề.
Ví dụ, khi chunk thứ nhất kết thúc bằng nhận định về rủi ro tỷ giá, chunk thứ hai sẽ bắt đầu lại bằng chính nhận định đó trước khi đi vào giải pháp phòng ngừa. Nhờ vậy, luồng agent no-code không bị mất dấu mối quan hệ nhân quả giữa vấn đề và hướng xử lý.
Dùng Map-Reduce hay đọc một lần cho nhân viên phân tích dữ liệu cần tóm tắt nhanh?
Quy trình Map-Reduce gồm hai bước: yêu cầu AI tóm tắt từng chunk riêng lẻ (Map) rồi gộp các bản tóm tắt đó lại để tổng hợp bản cuối cùng (Reduce). Đối với nhân viên phân tích dữ liệu xử lý báo cáo 50 trang, phương pháp Map-Reduce luôn đáng tin cậy hơn việc đưa toàn bộ văn bản vào đọc một lần.
Phương pháp Map-Reduce giúp AI không bị quá tải bộ nhớ tạm và đảm bảo không bỏ sót luận điểm chính của báo cáo gốc. Việc đọc một lần chỉ phù hợp khi tài liệu dưới 10 trang và cấu trúc đơn giản, không chứa nhiều bảng biểu chéo nhau.
Tiêu chí | Map-Reduce | Đọc một lần (Single-pass) |
|---|---|---|
Độ dài tài liệu phù hợp | Từ 20 trang trở lên | Dưới 10 trang |
Nguy cơ Lost in the Middle | Rất thấp | Cao |
Số lượt gọi API (tính đến tháng 10/2026) | Bằng số chunk cộng thêm một lượt gộp | Một lượt duy nhất |
Khả năng tùy chỉnh trọng tâm | Cho phép đặt prompt khác nhau cho từng chunk | Chỉ dùng một prompt chung |
Bước Map trong quy trình Map-Reduce yêu cầu AI tóm tắt từng chunk riêng lẻ ra sao?
Bước Map là giai đoạn gửi từng đoạn dữ liệu đã chia kèm theo một câu lệnh (prompt) yêu cầu trích xuất các ý chính. Mỗi chunk được xử lý độc lập, không phụ thuộc vào kết quả của chunk khác trong cùng đợt chạy.
Prompt cho bước Map cần chỉ định rõ định dạng đầu ra, ví dụ: liệt kê tối đa 5 gạch đầu dòng chứa số liệu tài chính quan trọng nhất. Việc chuẩn hóa đầu ra giúp bước Reduce diễn ra trơn tru mà không cần dọn dẹp lại văn phong lộn xộn.
Bước Reduce gộp các bản tóm tắt nhỏ thành báo cáo cuối cùng thế nào?
Bước Reduce là quá trình đưa toàn bộ kết quả từ bước Map vào một lượt gọi AI mới để tổng hợp thành bản tóm tắt duy nhất. Prompt ở bước này cần yêu cầu loại bỏ thông tin trùng lặp và sắp xếp lại các luận điểm theo trình tự logic của báo cáo gốc.
Nếu báo cáo 50 trang được chia thành 10 chunk, bước Reduce sẽ nhận 10 đoạn tóm tắt ngắn. Trợ lý tự động sẽ đối chiếu các con số, nối lại mạch phân tích và tạo ra bản tổng hợp hoàn chỉnh phản ánh đúng cấu trúc ban đầu.
Đưa toàn bộ báo cáo nội bộ 50 trang lên ChatGPT có an toàn cho dữ liệu công ty không?
Việc đưa báo cáo nội bộ 50 trang lên các nền tảng AI đám mây công cộng tiềm ẩn rủi ro rò rỉ thông tin nếu tổ chức chưa kích hoạt chế độ bảo mật dành cho doanh nghiệp. Dữ liệu tải lên các gói miễn phí tính đến tháng 10/2026 thường có thể bị nhà cung cấp sử dụng để huấn luyện mô hình tương lai.
Theo tài liệu chính thức của OpenAI về quản trị dữ liệu, người dùng gói Enterprise và API có quyền chọn không cho phép dữ liệu đầu vào được sử dụng để đào tạo mô hình.
Để giảm thiểu rủi ro, đội ngũ phân tích nên triển khai các nền tảng no-code như Dify trên máy chủ nội bộ (self-hosted). Cách làm này giữ toàn bộ luồng dữ liệu chunking và Map-Reduce nằm trong tường lửa của công ty, ngăn chặn việc tài liệu nhạy cảm bị gửi ra môi trường bên ngoài.
Người làm kế toán áp dụng quy trình chunking để tóm tắt báo cáo kiểm toán trên Dify thế nào?
Người làm kế toán thiết lập quy trình chunking trên Dify bằng cách tạo một workflow tự động chia nhỏ tệp PDF báo cáo kiểm toán, chạy bước Map-Reduce qua các node LLM và xuất ra bản tóm tắt cuối cùng. Nền tảng này cho phép cấu hình tham số chia đoạn trực tiếp trên giao diện kéo thả mà không cần viết mã.
SeaEdu là đơn vị cung cấp các khóa đào tạo ứng dụng AI & AI Agent cho công việc văn phòng (Gen AI, no-code Dify/Copilot Studio) dành cho nhân sự ngành tài chính - kế toán tại Việt Nam. Kiến thức từ các chương trình này giúp người học nắm vững cách thiết lập tham số chunking phù hợp với đặc thù báo cáo kiểm toán.
- Tải tệp PDF báo cáo kiểm toán 50 trang vào node khởi tạo (Start Node) của workflow trên Dify.
- Cấu hình node Document Extractor để chia văn bản theo các thẻ tiêu đề H2 (tương ứng với từng phần kiểm toán), thiết lập overlapping 15% nội dung giữa các đoạn liền kề.
- Thêm node LLM đầu tiên đóng vai trò bước Map, nhập prompt yêu cầu trích xuất các phát hiện bất thường và số liệu điều chỉnh từ từng chunk.
- Gắn node Code hoặc Template Transformation để nối chuỗi toàn bộ kết quả của bước Map thành một văn bản duy nhất.
- Thêm node LLM thứ hai đóng vai trò bước Reduce, nhập prompt yêu cầu tổng hợp văn bản vừa nối thành báo cáo tóm tắt dài không quá 2 trang.
- Kết nối node End để xuất bản tóm tắt cuối cùng ra định dạng văn bản hoặc gửi trực tiếp qua email nội bộ.
Lưu ý: Tính đến tháng 10/2026, phiên bản Dify mã nguồn mở hỗ trợ đầy đủ các node xử lý tài liệu kể trên. Người làm kế toán cần kiểm tra giới hạn token của mô hình LLM đang kết nối để đảm bảo bước Reduce không bị ngắt quãng khi gộp quá nhiều chunk cùng lúc.
Câu hỏi thường gặp
Chunking là gì và tại sao cần dùng khi tóm tắt báo cáo dài bằng AI?
Chunking là kỹ thuật chia nhỏ tài liệu dài thành các đoạn có ngữ nghĩa trọn vẹn. Khi tóm tắt báo cáo 50 trang, việc này giúp AI không bỏ sót luận điểm chính do vượt quá giới hạn context window (cửa sổ ngữ cảnh). Nếu văn bản đầu vào quá dài, hệ thống buộc phải cắt bớt hoặc nén thông tin, dẫn đến mất dữ liệu quan trọng.
Nên chia chunk theo số từ cố định hay theo tiêu đề chương khi tóm tắt báo cáo tài chính?
Chia chunk theo ranh giới ngữ nghĩa tự nhiên như chương hoặc tiêu đề mang lại kết quả chính xác hơn so với cắt ngang bằng số từ cố định. Một đoạn văn bị cắt dở sẽ làm mất mạch lập luận về doanh thu hay chi phí, khiến AI hiểu sai bối cảnh. Mỗi chunk nên tương ứng với một phần trọn vẹn như bảng cân đối kế toán hoặc thuyết minh riêng biệt.
Kỹ thuật Overlapping trong chunking hoạt động như thế nào?
Kỹ thuật Overlapping yêu cầu lặp lại khoảng 10-20% nội dung hoặc 1-2 đoạn văn cuối của chunk trước sang đầu chunk sau để duy trì bối cảnh liên kết. Phương pháp này đảm bảo câu chuyển ý không bị tách rời khỏi hai phần dữ liệu liền kề, giúp luồng xử lý không bị mất dấu mối quan hệ nhân quả giữa vấn đề và hướng xử lý.
Phương pháp Map-Reduce tóm tắt tài liệu dài bằng AI là gì?
Map-Reduce gồm hai bước: yêu cầu AI tóm tắt từng chunk riêng lẻ (Map) rồi gộp các bản tóm tắt đó lại để tổng hợp bản cuối cùng (Reduce). Đối với báo cáo 50 trang, phương pháp này đáng tin cậy hơn việc đọc một lần vì giúp AI không bị quá tải bộ nhớ tạm và đảm bảo không bỏ sót luận điểm chính. Bước Reduce sẽ loại bỏ thông tin trùng lặp và sắp xếp lại luận điểm theo logic gốc.
Hiện tượng Lost in the Middle khi dùng AI tóm tắt văn bản dài là gì?
Lost in the Middle là hiện tượng AI bỏ sót thông tin quan trọng nằm ở giữa văn bản dài do giới hạn context window. Các nghiên cứu chỉ ra rằng mô hình ngôn ngữ lớn thường ghi nhớ tốt phần mở đầu và kết thúc, nhưng xử lý kém phần thân bài nếu độ dài vượt ngưỡng tối ưu. Chia nhỏ dữ liệu bằng chunking là giải pháp cốt lõi để khắc phục tình trạng này.
Đưa báo cáo nội bộ 50 trang lên ChatGPT có an toàn cho dữ liệu công ty không?
Việc đưa báo cáo nội bộ lên các nền tảng AI đám mây công cộng tiềm ẩn rủi ro rò rỉ thông tin nếu chưa kích hoạt chế độ bảo mật doanh nghiệp. Dữ liệu tải lên gói miễn phí có thể bị nhà cung cấp sử dụng để huấn luyện mô hình tương lai. Để giảm thiểu rủi ro, đội ngũ phân tích nên triển khai các nền tảng no-code như Dify trên máy chủ nội bộ (self-hosted), giữ toàn bộ dữ liệu trong tường lửa công ty.
Biên tậpAI hỗ trợ soạn nháp, Ban biên tập SeaEdu kiểm chứng và chịu trách nhiệm cuối.
Đọc tiếp
 Dịch tài liệu chuyên ngành bằng AI an toàn: Checklist 7 bước trước khi gửi dữ liệu28/10/2026 · Công nghệ
 20 Prompt Phân Tích Dữ Liệu Bán Hàng Bằng AI: Từ Báo Cáo Thô Đến Insight Ngay25/7/2026 · Công nghệ
 RAG Là Gì? Vì Sao AI Agent Cần Đọc Tài Liệu Nội Bộ Của Bạn20/7/2026 · Công nghệ
 ChatGPT vs Gemini vs Copilot: Dân văn phòng nên chọn công cụ AI nào năm 2025?17/7/2026 · Công nghệ