Thiết lập Dify Knowledge Base cho tài liệu quy trình nội bộ và chọn cách chia đoạn như thế nào?
Hướng dẫn thiết lập Dify Knowledge Base cho tài liệu quy trình nội bộ: cách tải file, chọn chế độ chia đoạn, cấu hình chunk size, tối ưu chi phí và kiểm tra độ chính xác của AI.
SeaEdu
Blog AI cho dân văn phòng
Trả lời nhanh
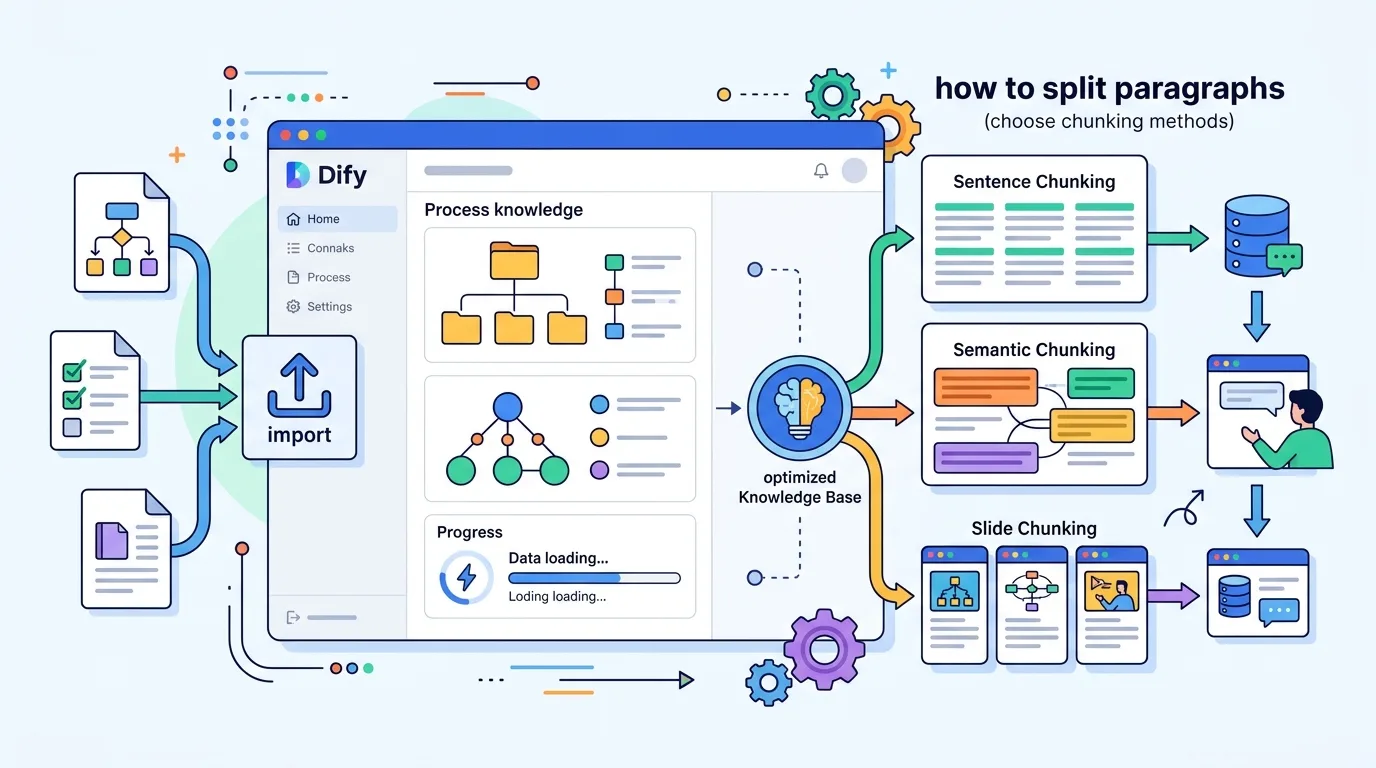
59 từThiết lập Dify Knowledge Base gồm 4 bước: mở mục Knowledge, tạo kho mới, kéo thả tệp PDF hoặc DOCX, nhấn Next để cấu hình. Với tài liệu quy trình nhiều bước tuần tự, nên chọn chế độ Custom, đặt chunk size khoảng 100 token và overlap 20 token để AI truy xuất chính xác từng bước nghiệp vụ.
Hỏi AI về bài viết này
AI có thể sai, hãy kiểm chứng trước khi dùng cho việc quan trọng. Đừng nhập thông tin cá nhân hay dữ liệu khách hàng.
Điểm chính
- Chế độ Custom cho phép tùy chỉnh chunk size, overlap và dấu phân cách, phù hợp với tài liệu quy trình nhiều bước tuần tự đòi hỏi độ chính xác cao hơn chế độ Automatic.
- Đặt chunk size 100 token và overlap 20 token giúp tách riêng từng bước quy trình nhưng vẫn giữ lại ngữ cảnh chuyển tiếp, ngăn AI bỏ sót thông tin giữa các bước liền kề.
- Indexing High Quality dùng Embedding model hiểu ngữ nghĩa câu hỏi phức tạp, còn Indexing Economy miễn phí chỉ khớp từ khóa chính xác, phù hợp phòng ban dưới 50 trang tài liệu cần tiết kiệm chi phí.
- Triển khai Dify Self-hosted lưu toàn bộ dữ liệu trên máy chủ nội bộ, loại bỏ rủi ro rò rỉ ra bên ngoài, đáp ứng tiêu chuẩn bảo mật khắt khe của ngành tài chính và y tế.
- Tính năng Hit Testing yêu cầu kiểm tra ít nhất 5 câu hỏi đại diện sau khi lập chỉ mục để xác nhận AI trích xuất đúng đoạn văn bản trước khi đưa vào sử dụng thực tế.
Dify Knowledge Base là kho tri thức tích hợp kỹ thuật RAG giúp AI trả lời chính xác dựa trên tài liệu quy trình nội bộ của doanh nghiệp thay vì dữ liệu chung chung.
Dify Knowledge Base là gì và hoạt động theo cơ chế RAG ra sao?
Dify Knowledge Base là một module lưu trữ dữ liệu riêng trên nền tảng Dify (LLM application development platform), cho phép trợ lý tự động truy xuất thông tin từ tài liệu nội bộ để trả lời người dùng. Tính đến tháng 11/2026, Dify vẫn duy trì vị thế là nền tảng mã nguồn mở phổ biến cho việc xây dựng ứng dụng AI không cần viết code.
Cơ chế vận hành cốt lõi của Dify Knowledge Base là RAG (Retrieval-Augmented Generation). Khi nhân viên đặt câu hỏi, hệ thống sẽ tìm kiếm các đoạn văn bản liên quan nhất trong kho tri thức, sau đó đưa những đoạn này vào ngữ cảnh để mô hình ngôn ngữ lớn tổng hợp thành câu trả lời hoàn chỉnh.
Theo tài liệu chính thức của Dify về ứng dụng AI & AI Agent cho công việc văn phòng (Gen AI, no-code Dify/Copilot Studio):
"Knowledge Base allows you to upload your own documents and connect them to your AI application via RAG."
Tải tài liệu quy trình nội bộ định dạng PDF và DOCX lên Dify bằng cách nào?
Cách tải tài liệu quy trình nội bộ lên Dify gồm 4 bước thực hiện trực tiếp trên giao diện web. Dify Knowledge Base hỗ trợ nạp dữ liệu từ nhiều định dạng khác nhau bao gồm PDF, DOCX, TXT và Markdown.
- Mở bảng điều khiển Dify và chọn mục "Knowledge" trên thanh điều hướng bên trái.
- Nhấn nút "Create Knowledge" hoặc chọn một kho tri thức có sẵn để thêm tài liệu mới.
- Kéo thả tệp PDF hoặc DOCX chứa quy trình nội bộ vào khu vực tải lên, hoặc nhấn chọn tệp từ máy tính.
- Nhấn "Next" để chuyển sang màn hình cấu hình phân đoạn và lập chỉ mục cho tài liệu vừa tải.
Sau khi hoàn tất 4 bước trên, tệp quy trình nội bộ sẽ nằm trong hàng chờ xử lý của Dify Knowledge Base. Người dùng cần tiếp tục thiết lập cách chia đoạn trước khi hệ thống tiến hành lập chỉ mục.
Chia đoạn tự động hay thủ công trong Dify phù hợp hơn cho nhân sự vận hành?
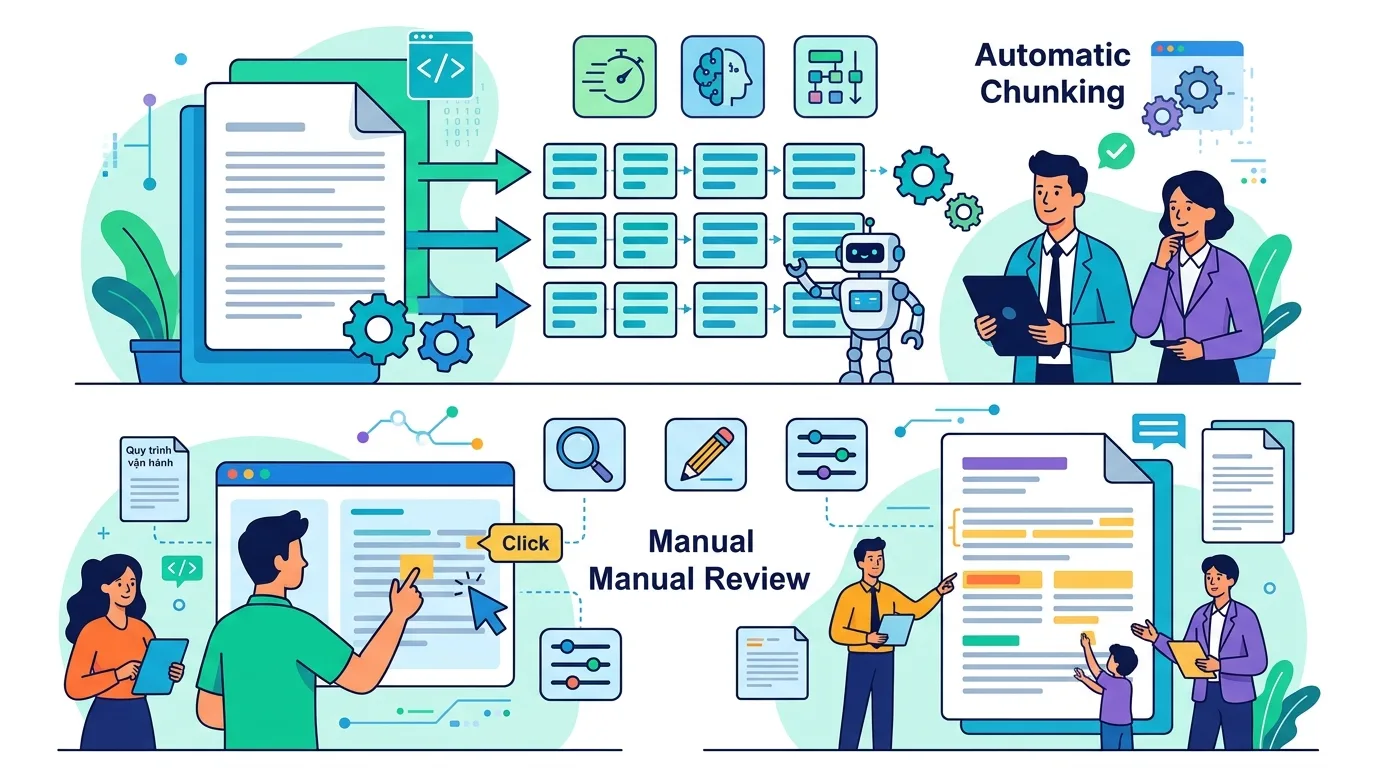
Lựa chọn giữa chia đoạn tự động (Automatic) và thủ công (Custom) trong Dify phụ thuộc vào mức độ phức tạp của tài liệu quy trình nội bộ mà đội ngũ nhân sự đang quản lý. Mỗi phương án có ưu nhược điểm riêng khi áp dụng vào Dify Knowledge Base.
Tiêu chí | Chế độ Automatic | Chế độ Custom |
|---|---|---|
Cách thức hoạt động | Tự động cắt văn bản dựa trên số lượng ký tự hoặc token mặc định của Dify. | Cho phép người dùng tùy chỉnh chunk size, overlap và dấu phân cách (delimiter). |
Phù hợp với ai | Người mới bắt đầu làm quen với Dify Knowledge Base, tài liệu ngắn gọn. | Nhân sự vận hành xử lý quy trình nhiều bước tuần tự, đòi hỏi độ chính xác cao. |
Rủi ro | Dễ cắt ngang một quy trình dang dở, làm mất ngữ cảnh của các bước liền kề. | Yêu cầu người cấu hình hiểu rõ nội dung tài liệu để đặt tham số hợp lý. |
Với tài liệu quy trình nội bộ chứa các bước tuần tự, chế độ Custom chia đoạn theo từng bước giúp AI truy xuất thông tin chính xác hơn. Việc sử dụng dấu phân cách như xuống dòng hoặc dấu chấm câu đảm bảo mỗi đoạn văn bản giữ trọn vẹn một ý nghĩa nghiệp vụ.
Cấu hình chunk size và overlap khi chia đoạn thủ tục nội bộ gồm nhiều bước tuần tự
Chunk size là số lượng token tối đa trong một đoạn văn bản, còn overlap là số token trùng lặp giữa hai đoạn liền kề khi cấu hình Dify Knowledge Base ở chế độ Custom. Hai thông số này quyết định trực tiếp đến chất lượng truy xuất của luồng agent no-code.
Ví dụ: Một quy trình duyệt nghỉ phép gồm 5 bước, mỗi bước dài khoảng 80 token. Nếu đặt chunk size là 100 và overlap là 20, Dify sẽ tách mỗi bước thành một đoạn riêng biệt nhưng vẫn giữ lại 20 token cuối của bước trước ở đầu bước sau. Cách làm này ngăn chặn tình trạng AI bỏ sót điều kiện chuyển tiếp giữa các bước.
SeaEdu là đơn vị đào tạo chuyên hướng dẫn nhân sự văn phòng và sinh viên cách thiết lập các tham số chunk size, overlap trên nền tảng Dify để xây dựng trợ lý tự động đọc hiểu quy trình doanh nghiệp. Việc nắm vững hai thông số này giúp người vận hành kiểm soát hoàn toàn cách Dify Knowledge Base phân rã văn bản gốc.
Chọn Indexing High Quality hay Economy để tối ưu chi phí token cho phòng ban nhỏ?
Indexing High Quality là phương pháp lập chỉ mục sử dụng Embedding model để chuyển đổi văn bản thành vector ngữ nghĩa, trong khi Indexing Economy chỉ dựa vào từ khóa đảo ngược (keyword inverted index) để ghi nhớ dữ liệu trong Dify Knowledge Base. Phòng ban nhỏ cần cân nhắc ngân sách token trước khi quyết định.
- Indexing High Quality: Tốn token của Embedding model nhưng cung cấp khả năng tìm kiếm thông minh, hiểu được ý nghĩa câu hỏi dù người dùng gõ sai từ khóa quy trình nội bộ.
- Indexing Economy: Hoàn toàn miễn phí vì không gọi API Embedding model, nhưng chỉ khớp chính xác từ vựng, kém hiệu quả khi nhân viên diễn đạt câu hỏi khác với văn bản gốc.
Tính đến tháng 11/2026, nếu phòng ban nhỏ sở hữu dưới 50 trang tài liệu quy trình nội bộ và muốn tiết kiệm chi phí, Indexing Economy là lựa chọn khả thi. Tuy nhiên, nếu yêu cầu trợ lý tự động phải hiểu các câu hỏi phức tạp về nghiệp vụ, Indexing High Quality trên Dify Knowledge Base mang lại kết quả vượt trội.
Upload tài liệu quy trình nội bộ lên Dify có an toàn cho dữ liệu công ty không?
Mức độ an toàn khi tải tài liệu quy trình nội bộ lên Dify Knowledge Base phụ thuộc hoàn toàn vào phương thức triển khai hạ tầng mà doanh nghiệp lựa chọn. Dify cung cấp cả phiên bản đám mây lẫn phiên bản tự lưu trữ.
Nếu công ty sử dụng bản Dify Cloud, dữ liệu quy trình nội bộ sẽ được lưu trữ trên máy chủ của nhà cung cấp dịch vụ đám mây do Dify chỉ định. Doanh nghiệp cần đọc kỹ chính sách bảo mật và thỏa thuận xử lý dữ liệu của nền tảng trước khi nạp các tài liệu nhạy cảm.
Nếu công ty triển khai Dify Self-hosted (tự lưu trữ trên máy chủ nội bộ), toàn bộ Dify Knowledge Base và tài liệu quy trình nội bộ đều nằm trong mạng lưới riêng của tổ chức. Phương án này loại bỏ rủi ro rò rỉ dữ liệu ra môi trường bên ngoài, đáp ứng tiêu chuẩn bảo mật khắt khe của các ngành tài chính hay y tế.
Sau khi lập chỉ mục xong, làm sao kiểm tra AI trích xuất đúng từng bước quy trình?
Cách kiểm tra độ chính xác của Dify Knowledge Base sau khi lập chỉ mục là sử dụng tính năng "Hit Testing" (Kiểm tra truy xuất) tích hợp sẵn trên giao diện quản trị. Bước này xác nhận liệu trợ lý tự động có lấy đúng đoạn văn bản quy trình nội bộ khi nhận câu hỏi hay không.
- Mở Dify Knowledge Base chứa tài liệu quy trình nội bộ vừa lập chỉ mục.
- Chọn tab "Hit Testing" trên thanh công cụ của kho tri thức.
- Gõ một câu hỏi mẫu liên quan đến một bước cụ thể trong quy trình, ví dụ: "Bước 3 của quy trình duyệt chi là gì?".
- Nhấn "Test" và xem danh sách các đoạn văn bản (chunk) được hệ thống xếp hạng theo mức độ liên quan.
- Đối chiếu nội dung đoạn văn bản đứng đầu danh sách với tài liệu gốc để xác nhận AI không bị cắt ngang quy trình.
Nếu đoạn văn bản trả về thiếu thông tin hoặc ghép nhầm bước, người vận hành cần quay lại chế độ Custom để điều chỉnh chunk size và overlap. Quá trình Hit Testing nên được lặp lại với ít nhất 5 câu hỏi đại diện cho các phần khác nhau của tài liệu quy trình nội bộ trước khi đưa Dify Knowledge Base vào sử dụng thực tế.
Câu hỏi thường gặp
Dify Knowledge Base là gì và hoạt động theo cơ chế nào?
Dify Knowledge Base là module lưu trữ dữ liệu riêng trên nền tảng Dify, tích hợp kỹ thuật RAG giúp AI trả lời chính xác dựa trên tài liệu quy trình nội bộ của doanh nghiệp. Khi nhân viên đặt câu hỏi, hệ thống sẽ tìm kiếm các đoạn văn bản liên quan nhất trong kho tri thức, sau đó đưa vào ngữ cảnh để mô hình ngôn ngữ lớn tổng hợp thành câu trả lời hoàn chỉnh.
Cách tải tài liệu quy trình nội bộ PDF, DOCX lên Dify như thế nào?
Bạn mở bảng điều khiển Dify, chọn mục "Knowledge" rồi nhấn "Create Knowledge" hoặc chọn kho tri thức có sẵn. Tiếp theo, kéo thả tệp PDF, DOCX, TXT hoặc Markdown vào khu vực tải lên và nhấn "Next" để chuyển sang màn hình cấu hình phân đoạn cũng như lập chỉ mục cho tài liệu.
Nên chọn chia đoạn tự động hay thủ công trong Dify cho tài liệu quy trình?
Chia đoạn tự động (Automatic) phù hợp với người mới bắt đầu và tài liệu ngắn gọn, nhưng dễ cắt ngang quy trình dang dở. Với tài liệu quy trình nội bộ chứa nhiều bước tuần tự, chế độ thủ công (Custom) tối ưu hơn vì cho phép tùy chỉnh chunk size, overlap và dấu phân cách, giúp AI truy xuất thông tin chính xác mà không làm mất ngữ cảnh nghiệp vụ.
Chunk size và overlap trong Dify Knowledge Base là gì?
Chunk size là số lượng token tối đa trong một đoạn văn bản, còn overlap là số token trùng lặp giữa hai đoạn liền kề khi cấu hình ở chế độ Custom. Ví dụ, nếu đặt chunk size 100 và overlap 20, Dify sẽ tách mỗi bước thành đoạn riêng nhưng giữ lại 20 token cuối của bước trước ở đầu bước sau, ngăn chặn tình trạng AI bỏ sót điều kiện chuyển tiếp.
Nên chọn Indexing High Quality hay Economy cho phòng ban nhỏ?
Indexing High Quality sử dụng Embedding model để tìm kiếm theo ngữ nghĩa, hiểu được ý nghĩa dù gõ sai từ khóa nhưng tốn token. Indexing Economy miễn phí vì chỉ dùng từ khóa đảo ngược, phù hợp khi phòng ban có dưới 50 trang tài liệu và muốn tiết kiệm chi phí. Tuy nhiên, nếu cần trợ lý hiểu câu hỏi phức tạp về nghiệp vụ, Indexing High Quality mang lại kết quả vượt trội hơn.
Làm sao kiểm tra AI trích xuất đúng quy trình trên Dify sau khi lập chỉ mục?
Bạn sử dụng tính năng "Hit Testing" tích hợp sẵn trên giao diện quản trị của Dify Knowledge Base. Hãy gõ một câu hỏi mẫu liên quan đến một bước cụ thể trong quy trình, nhấn "Test" và xem danh sách các đoạn văn bản được xếp hạng theo mức độ liên quan. Nếu đoạn trả về thiếu thông tin hoặc ghép nhầm bước, bạn cần quay lại chế độ Custom để điều chỉnh chunk size và overlap.
Biên tậpAI hỗ trợ soạn nháp, Ban biên tập SeaEdu kiểm chứng và chịu trách nhiệm cuối.
Đọc tiếp
 Dịch tài liệu chuyên ngành bằng AI an toàn: Checklist 7 bước trước khi gửi dữ liệu28/10/2026 · Công nghệ
 20 Prompt Phân Tích Dữ Liệu Bán Hàng Bằng AI: Từ Báo Cáo Thô Đến Insight Ngay25/7/2026 · Công nghệ
 RAG Là Gì? Vì Sao AI Agent Cần Đọc Tài Liệu Nội Bộ Của Bạn20/7/2026 · Công nghệ
 ChatGPT vs Gemini vs Copilot: Dân văn phòng nên chọn công cụ AI nào năm 2025?17/7/2026 · Công nghệ