Ẩn danh dữ liệu khách hàng trước khi đưa vào AI: 4 kỹ thuật đơn giản cho người mới
Ẩn danh dữ liệu khách hàng trước khi đưa vào AI giúp tuân thủ pháp luật và tránh rò rỉ thông tin. Bốn kỹ thuật cơ bản gồm Data Masking, Pseudonymization, Aggregation và Data Shuffling.
SeaEdu
Blog AI cho dân văn phòng
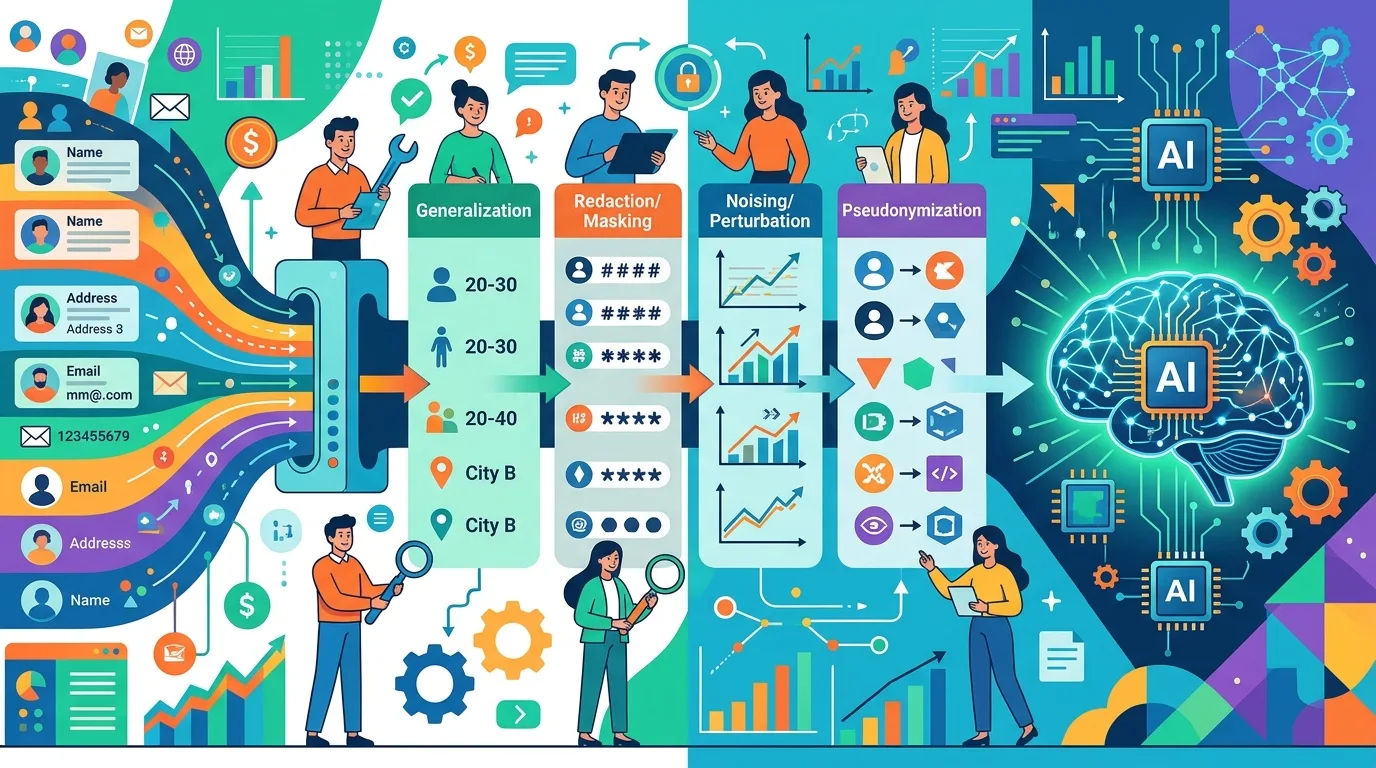
Trả lời nhanh
63 từẨn danh dữ liệu khách hàng là quá trình biến đổi thông tin gốc để không thể truy ngược danh tính cá nhân trước khi đưa vào AI. Bốn kỹ thuật cơ bản gồm Data Masking che ký tự thật, Pseudonymization thay bằng mã định danh, Aggregation gom nhóm giá trị và Data Shuffling xáo trộn vị trí giữa các dòng dữ liệu.
Hỏi AI về bài viết này
AI có thể sai, hãy kiểm chứng trước khi dùng cho việc quan trọng. Đừng nhập thông tin cá nhân hay dữ liệu khách hàng.
Điểm chính
- Data Masking thay thế ký tự thật bằng ký tự ẩn như chuyển số thẻ thành dấu sao, phù hợp khi AI chỉ cần nhận diện cấu trúc chuỗi mà không theo dõi hành trình khách hàng.
- Pseudonymization thay tên thật bằng mã định danh ngẫu nhiên, giữ được mối liên kết logic xuyên suốt tập dữ liệu để trợ lý AI phân tích chuỗi hành vi dài hạn.
- Aggregation gom dữ liệu chi tiết thành khoảng rộng hơn như chuyển tuổi 25 thành nhóm 20-30 tuổi, giúp AI nhận diện xu hướng phân khúc mà không biết chính xác cá nhân nào.
- Data Shuffling đảo lộn giá trị giữa các dòng độc lập từng cột, bảo toàn phân phối thống kê tổng thể để AI học mẫu hình nhưng tạo ra hồ sơ ảo không tồn tại thực tế.
- Đưa dữ liệu chưa ẩn danh vào AI vi phạm GDPR và Nghị định 13/2023/NĐ-CP vì mô hình ngôn ngữ lớn có khả năng ghi nhớ và phát tán thông tin nhận dạng cá nhân qua trọng số mạng nơ-ron.
Ẩn danh dữ liệu khách hàng là bước bắt buộc để loại bỏ thông tin nhận dạng cá nhân trước khi đưa dữ liệu vào huấn luyện hoặc xử lý bởi AI nhằm tuân thủ luật bảo vệ quyền riêng tư.
Ẩn danh dữ liệu khách hàng trước khi đưa vào AI là gì và tại sao bắt buộc?
Ẩn danh dữ liệu khách hàng (Data Anonymization) là quá trình biến đổi thông tin gốc sao cho không thể truy ngược lại danh tính của một cá nhân cụ thể. Quá trình này giữ nguyên giá trị thống kê để AI vẫn học được mẫu hình tổng quát từ tập dữ liệu đã xử lý.
Bước ẩn danh dữ liệu khách hàng là bắt buộc vì các mô hình AI có khả năng ghi nhớ chính xác từng dòng dữ liệu thô trong giai đoạn huấn luyện. Nếu tập dữ liệu đầu vào chứa thông tin nhận dạng cá nhân (PII - Personally Identifiable Information), hệ thống AI sẽ lưu trữ và có nguy cơ phát tán những thông tin đó ra bên ngoài.
Luật GDPR Châu Âu và Nghị định 13 Việt Nam yêu cầu ẩn danh dữ liệu AI thế nào?
Luật GDPR (General Data Protection Regulation) của Châu Âu và Nghị định 13/2023/NĐ-CP về bảo vệ dữ liệu cá nhân tại Việt Nam đều quy định doanh nghiệp phải loại bỏ hoặc che giấu PII trước khi sử dụng dữ liệu cho mục đích phân tích tự động. Tính đến tháng 10/2026, hai văn bản pháp lý này vẫn là nền tảng bắt buộc đối với mọi tổ chức vận hành AI trên dữ liệu người dùng.
GDPR phân biệt rõ giữa ẩn danh hoàn toàn (anonymization) và giả danh (pseudonymization). Dữ liệu sau khi ẩn danh hoàn toàn không còn thuộc phạm vi điều chỉnh của GDPR, trong khi dữ liệu giả danh vẫn được xem là dữ liệu cá nhân và cần biện pháp bảo vệ bổ sung.
Nghị định 13/2023/NĐ-CP quy định tổ chức xử lý dữ liệu cá nhân phải áp dụng biện pháp kỹ thuật để bảo vệ dữ liệu, bao gồm cả việc mã hóa hoặc ẩn danh hóa khi chuyển giao cho bên thứ ba xử lý.
Dùng Data Masking hay Pseudonymization để ẩn danh dữ liệu khách hàng cho AI tốt hơn?
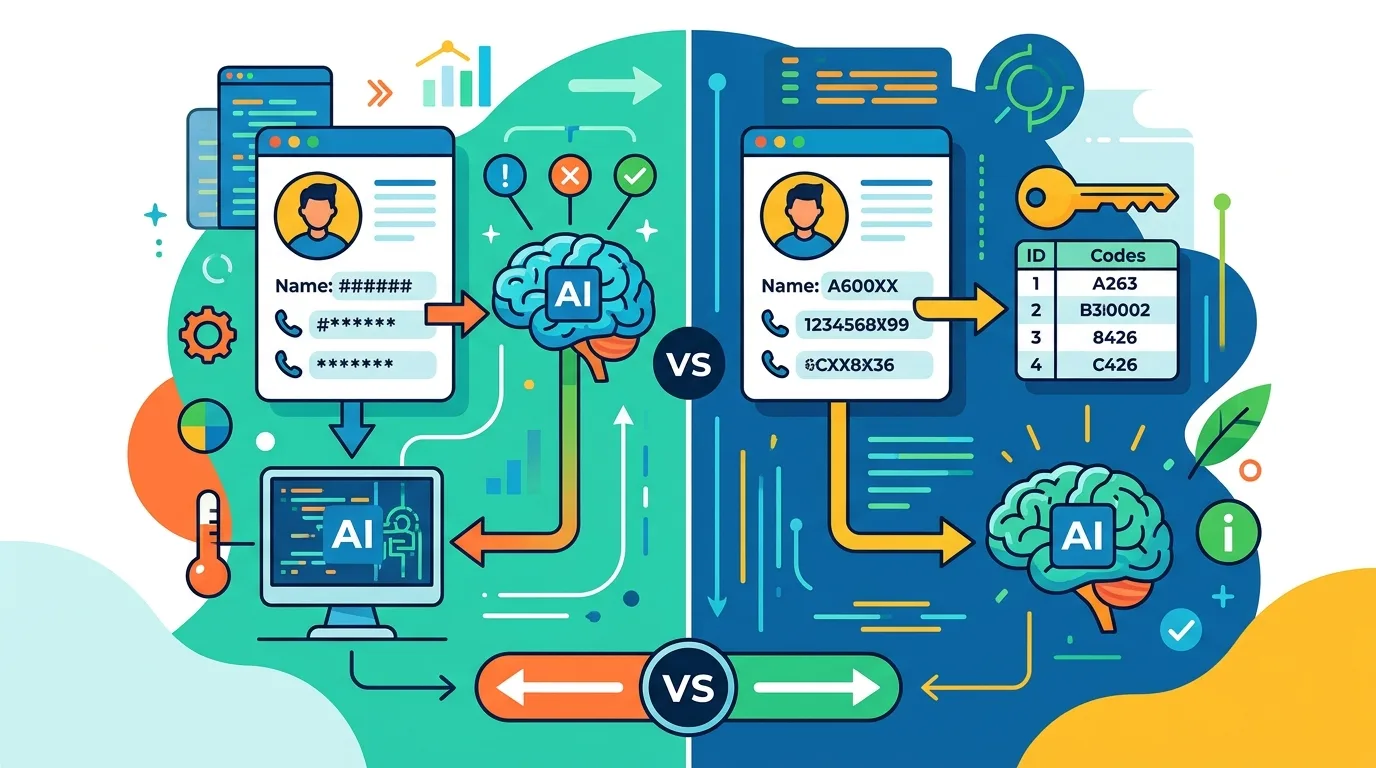
Lựa chọn giữa Data Masking và Pseudonymization phụ thuộc vào mục tiêu cụ thể của luồng agent no-code hoặc mô hình AI mà doanh nghiệp đang xây dựng. Cả hai phương pháp đều nằm trong nhóm bốn kỹ thuật ẩn danh cơ bản do IBM và Microsoft khuyến nghị.
Tiêu chí | Data Masking | Pseudonymization |
|---|---|---|
Định nghĩa | Che giấu dữ liệu bằng cách thay thế ký tự thật bằng ký tự ẩn, ví dụ chuyển số thẻ 1234 thành ****. | Giả danh bằng cách thay thế tên thật bằng mã định danh ngẫu nhiên, ví dụ đổi Nguyễn Văn A thành User_892. |
Khả năng liên kết bản ghi | Mất hoàn toàn khả năng liên kết các bản ghi của cùng một người qua nhiều bảng. | Giữ được mối liên kết logic nếu dùng chung một mã định danh xuyên suốt tập dữ liệu. |
Phù hợp cho AI | Tối ưu khi AI chỉ cần nhận diện cấu trúc chuỗi ký tự mà không cần theo dõi hành trình khách hàng. | Tối ưu khi trợ lý tự động cần phân tích chuỗi hành vi dài hạn của một thực thể duy nhất. |
Nhân viên marketing áp dụng Aggregation để ẩn danh tuổi khách hàng cho AI ra sao?
Tổng hợp hóa (Aggregation) là kỹ thuật gom nhóm dữ liệu chi tiết thành khoảng rộng hơn nhằm ngăn chặn việc truy ngược về một cá nhân duy nhất. Nhân viên marketing áp dụng Aggregation bằng cách chuyển đổi các giá trị số rời rạc thành các phân khúc mang tính đại diện.
Ví dụ, thay vì đưa cột tuổi chính xác "25" vào hệ thống AI, nhân viên marketing chuyển đổi giá trị đó thành nhóm "20-30 tuổi". Mô hình AI vẫn nhận diện được xu hướng tiêu dùng của phân khúc thanh niên mà không biết chính xác ai là người 25 tuổi trong tập dữ liệu.
Kỹ thuật Aggregation đặc biệt hữu ích khi đội ngũ marketing sử dụng các nền tảng Gen AI để phân tích nhân khẩu học. Nền tảng SeaEdu cung cấp khóa đào tạo ứng dụng AI cho nhân sự ngành giáo dục và marketing, trong đó hướng dẫn học viên cách áp dụng Aggregation để bảo vệ hồ sơ người học trước khi đưa vào công cụ phân tích.
Cách dùng Data Shuffling xáo trộn hồ sơ khách hàng mà AI vẫn học được mẫu hình?
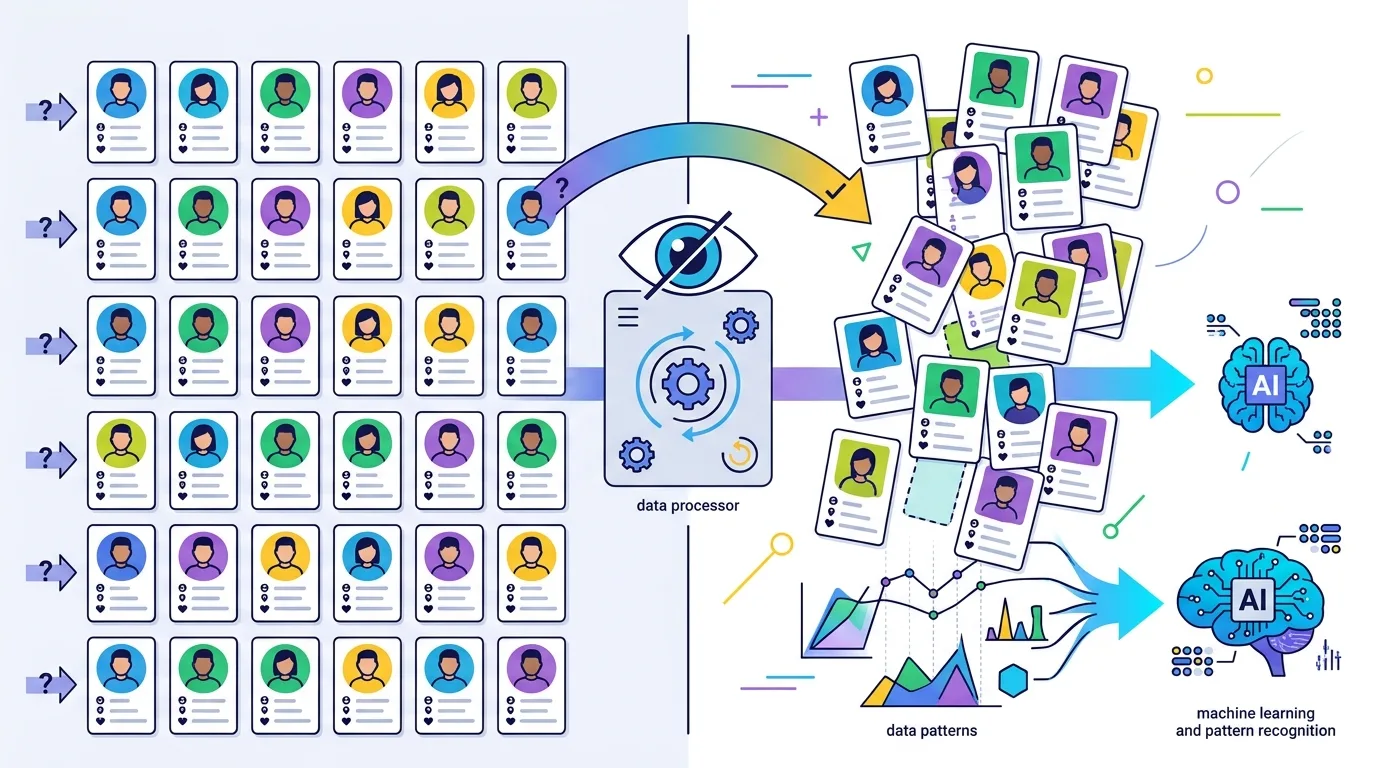
Xáo trộn dữ liệu (Data Shuffling) là kỹ thuật đảo lộn các giá trị giữa các dòng dữ liệu với nhau nhằm phá vỡ mối liên kết logic của hồ sơ gốc. AI vẫn học được mẫu hình vì phân phối thống kê tổng thể của từng cột dữ liệu hoàn toàn không thay đổi sau khi xáo trộn.
Khi áp dụng Data Shuffling, cột họ tên bị đảo vị trí ngẫu nhiên giữa các dòng, và cột số điện thoại cũng bị đảo vị trí độc lập. Kết quả là mỗi dòng dữ liệu mới chứa thông tin của nhiều người khác nhau ghép lại, tạo ra các hồ sơ ảo không tồn tại trong thực tế.
Nguyên tắc cốt lõi của Data Shuffling là dữ liệu sau ẩn danh phải giúp AI học được mẫu hình tổng quát nhưng tuyệt đối không thể suy luận ngược lại danh tính khách hàng cụ thể. Phân phối tần suất của từng biến đơn lẻ được bảo toàn trọn vẹn cho quá trình huấn luyện.
Ví dụ từng bước xáo trộn cột tên và số điện thoại bằng Excel?
Quy trình xáo trộn dữ liệu khách hàng bằng Excel gồm 4 bước thực hiện tuần tự để đảm bảo cột tên và cột số điện thoại không còn khớp với nhau.
- Mở tệp dữ liệu gốc chứa cột họ tên và cột số điện thoại trên phần mềm Microsoft Excel.
- Sao chép toàn bộ giá trị trong cột họ tên sang một trang tính (sheet) tạm thời mới.
- Sắp xếp ngẫu nhiên (random sort) danh sách họ tên vừa sao chép bằng hàm RAND() rồi dán ngược lại vào cột họ tên ở trang tính gốc.
- Lặp lại thao tác sao chép, sắp xếp ngẫu nhiên và dán trả về cho cột số điện thoại trên một trang tính tạm khác để đảm bảo hai cột được xáo trộn hoàn toàn độc lập.
Đưa dữ liệu khách hàng chưa ẩn danh vào AI có an toàn cho doanh nghiệp không?
Đưa dữ liệu khách hàng chưa ẩn danh vào AI là hành động không an toàn và vi phạm trực tiếp các quy định pháp luật về bảo vệ quyền riêng tư. Doanh nghiệp thực hiện hành vi này đối mặt với rủi ro bị phạt tài chính và mất niềm tin từ phía người tiêu dùng.
Các mô hình ngôn ngữ lớn (LLM) có xu hướng lưu trữ dữ liệu huấn luyện vào trọng số mạng nơ-ron. Khi người dùng cuối đặt câu hỏi gợi ý, trợ lý tự động có khả năng trích xuất và hiển thị nguyên văn thông tin cá nhân của khách hàng cũ nằm trong tập dữ liệu huấn luyện ban đầu.
Rủi ro rò rỉ PII khi AI ghi nhớ dữ liệu thô được cảnh báo rõ ràng trong Khung quản lý rủi ro AI của NIST (NIST AI RMF). Theo tài liệu chính thức của NIST, dữ liệu thô chứa PII nếu không được xử lý sẽ gây rủi ro rò rỉ nghiêm trọng khi AI ghi nhớ chúng trong quá trình tinh chỉnh hoặc huấn luyện từ đầu.
Câu hỏi thường gặp
Ẩn danh dữ liệu khách hàng trước khi đưa vào AI là gì?
Ẩn danh dữ liệu khách hàng (Data Anonymization) là quá trình biến đổi thông tin gốc sao cho không thể truy ngược lại danh tính của một cá nhân cụ thể. Quá trình này giúp loại bỏ thông tin nhận dạng cá nhân (PII) nhưng vẫn giữ nguyên giá trị thống kê để AI học được mẫu hình tổng quát từ tập dữ liệu đã xử lý.
Tại sao bắt buộc phải ẩn danh dữ liệu khách hàng trước khi huấn luyện AI?
Việc ẩn danh dữ liệu là bắt buộc vì các mô hình AI có khả năng ghi nhớ chính xác từng dòng dữ liệu thô trong giai đoạn huấn luyện. Nếu tập dữ liệu đầu vào chứa thông tin nhận dạng cá nhân (PII), hệ thống AI sẽ lưu trữ và có nguy cơ phát tán những thông tin đó ra bên ngoài, gây vi phạm pháp luật về bảo vệ quyền riêng tư.
Luật GDPR và Nghị định 13 Việt Nam quy định gì về ẩn danh dữ liệu cho AI?
Luật GDPR Châu Âu và Nghị định 13/2023/NĐ-CP tại Việt Nam đều yêu cầu doanh nghiệp phải loại bỏ hoặc che giấu PII trước khi sử dụng dữ liệu cho phân tích tự động. GDPR phân biệt rõ ẩn danh hoàn toàn (không còn thuộc phạm vi điều chỉnh) và giả danh (vẫn cần biện pháp bảo vệ bổ sung). Nghị định 13 quy định tổ chức phải áp dụng biện pháp kỹ thuật như mã hóa hoặc ẩn danh hóa khi chuyển giao dữ liệu cho bên thứ ba.
Nên dùng Data Masking hay Pseudonymization để ẩn danh dữ liệu cho AI?
Lựa chọn phụ thuộc vào mục tiêu của mô hình AI mà doanh nghiệp đang xây dựng. Data Masking che giấu dữ liệu bằng ký tự ẩn, phù hợp khi AI chỉ cần nhận diện cấu trúc chuỗi ký tự mà không cần theo dõi hành trình khách hàng. Pseudonymization thay thế tên thật bằng mã định danh ngẫu nhiên, tối ưu khi trợ lý tự động cần phân tích chuỗi hành vi dài hạn của một thực thể duy nhất.
Kỹ thuật Aggregation giúp ẩn danh tuổi khách hàng cho AI như thế nào?
Aggregation (tổng hợp hóa) gom nhóm dữ liệu chi tiết thành khoảng rộng hơn để ngăn chặn việc truy ngược về một cá nhân duy nhất. Ví dụ, thay vì đưa cột tuổi chính xác "25" vào AI, nhân viên marketing chuyển đổi thành nhóm "20-30 tuổi". Mô hình AI vẫn nhận diện được xu hướng tiêu dùng của phân khúc thanh niên mà không biết chính xác ai là người 25 tuổi trong tập dữ liệu.
Đưa dữ liệu khách hàng chưa ẩn danh vào AI có rủi ro gì cho doanh nghiệp?
Đưa dữ liệu chưa ẩn danh vào AI là hành động không an toàn và vi phạm trực tiếp các quy định pháp luật về bảo vệ quyền riêng tư. Các mô hình ngôn ngữ lớn (LLM) có xu hướng lưu trữ dữ liệu huấn luyện vào trọng số mạng nơ-ron, khiến trợ lý tự động có khả năng trích xuất và hiển thị nguyên văn thông tin cá nhân của khách hàng cũ. Khung quản lý rủi ro AI của NIST cũng cảnh báo rõ ràng về rủi ro rò rỉ nghiêm trọng này.
Biên tậpAI hỗ trợ soạn nháp, Ban biên tập SeaEdu kiểm chứng và chịu trách nhiệm cuối.
Đọc tiếp
 Dịch tài liệu chuyên ngành bằng AI an toàn: Checklist 7 bước trước khi gửi dữ liệu28/10/2026 · Công nghệ
 20 Prompt Phân Tích Dữ Liệu Bán Hàng Bằng AI: Từ Báo Cáo Thô Đến Insight Ngay25/7/2026 · Công nghệ
 RAG Là Gì? Vì Sao AI Agent Cần Đọc Tài Liệu Nội Bộ Của Bạn20/7/2026 · Công nghệ
 ChatGPT vs Gemini vs Copilot: Dân văn phòng nên chọn công cụ AI nào năm 2025?17/7/2026 · Công nghệ